



Equipo Shieldworkz
Una alerta de ransomware en una computadora portátil corporativa y un alto horno parado nunca deberían sentirse como la misma emergencia, pero en la mayoría de los entornos industriales actuales, desencadenan la misma respuesta lenta y manual. Los equipos de seguridad aún pasan horas valiosas recopilando registros a mano, llamando a los ingenieros de la planta para confirmar qué hace realmente un dispositivo e aislando interruptores de forma manual mientras la producción sigue funcionando a ciegas. Esa brecha entre la detección y la contención es exactamente donde viven los atacantes, y es precisamente lo que la Detección y Respuesta de Red (NDR) moderna, combinada con una segmentación de red disciplinada y una arquitectura de confianza cero, está diseñada para cerrar.
Este no es un problema teórico para los líderes de seguridad de OT, ingenieros de ICS, gerentes de planta y CISOs que supervisan entornos de manufactura, energía e infraestructura crítica. Es la realidad operativa que impulsa las conversaciones presupuestarias, las revisiones de riesgos a nivel de junta directiva y las renovaciones de seguros en todo el sector industrial. Comprender cómo funciona realmente la respuesta automatizada ante incidentes, y por qué depende por completo de la segmentación y del modelo de confianza subyacente, es ahora una competencia central para cualquier persona responsable de mantener las operaciones industriales seguras, disponibles y resilientes.
La superficie de ataque se ha trasladado al piso de producción
Durante décadas, los sistemas de control industrial estuvieron protegidos por una suposición simple: estaban aislados. Redes con brecha de aire (air-gapped), protocolos propietarios y hardware especializado creaban un foso natural alrededor de los controladores lógicos programables, las unidades de terminal remota y los sistemas de control de supervisión. Ese foso prácticamente ha desaparecido. Las redes de TI y OT convergen para lograr una mayor eficiencia, los proveedores remotos necesitan acceso para el mantenimiento, las plataformas de análisis e histórico basadas en la nube extraen datos directamente del piso de planta, y los mismos grupos de ransomware que atacan a hospitales y bancos han aprendido que los operadores industriales pagan rápido para evitar el tiempo de inactividad de la producción.
Varios incidentes documentados públicamente ilustran la rapidez con la que ocurrió este cambio. Los ataques de 2015 y 2016 a la red eléctrica de Ucrania utilizaron malware que manipuló directamente los disyuntores y los equipos de las subestaciones, cortando la electricidad a cientos de miles de clientes y demostrando que los atacantes podían llegar hasta lo más profundo de la tecnología operativa, no solo a los sistemas de TI. En 2017, se descubrió un malware conocido como Triton, o Trisis, dirigido a los sistemas instrumentados de seguridad de una instalación petroquímica en Arabia Saudita, los mismos controladores diseñados para prevenir explosiones y proteger la vida humana. Ese incidente sigue siendo una de las advertencias más claras que ha recibido el sector industrial: los atacantes ya no solo buscan datos, están sondeando los sistemas que mantienen seguras a las personas.
Más cerca de casa para muchos fabricantes, el ataque de ransomware de 2019 a Norsk Hydro obligó al productor de aluminio a cambiar gran parte de sus operaciones a procesos manuales durante semanas, con un costo de decenas de millones de dólares. Y el incidente de Colonial Pipeline en 2021 demostró cómo un ataque que técnicamente permaneció dentro de los sistemas de TI aún podía obligar a los operadores a cerrar por completo un oleoducto de combustible por precaución, debido a la falta de confianza en el límite entre su red comercial y su red operativa. Ninguna de estas organizaciones fue descuidada. Simplemente carecían de la segmentación, visibilidad y capacidad de respuesta automatizada necesarias para contener un incidente antes de que obligara a un cierre.
Por qué la respuesta manual ante incidentes ya no funciona en entornos industriales
El modelo tradicional de respuesta ante incidentes fue diseñado para TI: un analista revisa una alerta, verifica algunos sistemas y decide si aísla una computadora portátil o restablece una credencial. Aplicado a OT, ese modelo falla de tres maneras específicas.
El tiempo de permanencia (dwell time) es más largo y peligroso. Históricamente, las intrusiones industriales han pasado desapercibidas durante periodos prolongados porque el tráfico de OT rara vez se monitorea con el mismo rigor que el de TI, lo que da a los atacantes tiempo para mapear la red e identificar objetivos de alto valor, como los sistemas de seguridad.
La fatiga por alertas golpea con más fuerza. Las herramientas heredadas de detección de intrusiones creadas para la TI empresarial generan un volumen enorme de ruido cuando se dirigen a protocolos de OT que nunca fueron diseñadas para entender, enterrando el puñado de alertas genuinamente peligrosas.
Las decisiones de contención conllevan consecuencias físicas. Un analista no puede simplemente cortar la energía a un segmento de la forma en que aislaría una computadora portátil comprometida; hacerlo de manera incorrecta puede desencadenar un evento de seguridad, dañar el equipo o detener un proceso que requiere horas para reiniciarse de manera segura.
El resultado es un ciclo de respuesta que se mide en horas o días en lugar de minutos, precisamente la ventana que los atacantes necesitan para pasar del acceso inicial a un impacto operativo real. Cerrar esa ventana requiere dos cosas que funcionen en conjunto: automatización que entienda el contexto de OT y una arquitectura de red segmentada que haga posible una contención rápida y segura en primer lugar.
El costo empresarial de una contención retrasada
Los líderes de seguridad a menudo obtienen presupuesto para nuevas herramientas al hablar sobre la probabilidad de una brecha. En los entornos industriales, la cifra más persuasiva suele ser más simple: el costo de cada hora que una línea, unidad o instalación permanece inactiva mientras un equipo investiga manualmente lo sucedido. El tiempo de inactividad no planificado en industrias de proceso continuo, como la química, la energía y la manufactura pesada, suele ascender a decenas de miles de dólares por hora una vez que se combinan la pérdida de producción, los materiales echados a perder, las penalizaciones contractuales y los costos de reinicio, y un cierre preventivo total en múltiples líneas multiplica esa cifra rápidamente.
La contención retrasada agrava este costo de tres maneras distintas. Primero, la pérdida directa de producción crece por cada hora que un incidente permanece sin resolver. Segundo, el alcance de una investigación manual tiende a expandirse a medida que se desconectan más sistemas por precaución, simplemente porque nadie puede decir con confianza cuáles están afectados. Tercero, la recuperación en sí toma más tiempo, porque reiniciar procesos industriales complejos de manera segura después de una parada no planificada rara vez es tan simple como volver a encender un interruptor; a menudo requiere volver a validar los enclavamientos de seguridad y los parámetros del proceso antes de que la producción pueda reanudarse.
Modelo de respuesta | Ventana típica de detección a contención | Alcance del cierre preventivo |
Investigación manual basada en registros | De horas a varios días | A menudo en toda la planta o en múltiples líneas, por precaución |
Alertas de NDR sin respuesta automatizada | Menos de una hora para detectar, horas para actuar | Reducido, pero aún dependiente de la ejecución manual |
NDR automatizado + SOAR con segmentación | Minutos desde la detección hasta la primera acción de contención | Limitado a la zona segmentada específica afectada |
Tabla 3: Cómo la madurez de la respuesta define directamente el costo operativo de un incidente.
Planteado de esta manera, la respuesta automatizada ante incidentes y la segmentación dejan de parecer un simple gasto de seguridad y comienzan a verse como gestión de riesgos operativos, la misma categoría de inversión que los generadores de respaldo o los sistemas de seguridad redundantes, justificados por el tiempo de inactividad evitado en lugar de solo por la brecha evitada.
Lo que realmente significa el NDR moderno para las redes OT
La Detección y Respuesta de Red diseñada para entornos industriales es una disciplina fundamentalmente diferente a las herramientas de detección de intrusiones que la mayoría de los equipos de TI ya operan. Las herramientas genéricas centradas en TI inspeccionan los encabezados de los paquetes e identifican firmas conocidas; nunca fueron diseñadas para analizar Modbus, DNP3, EtherNet/IP o protocolos propietarios de proveedores, y no pueden distinguir entre un comando de mantenimiento programado y uno malicioso. En su lugar, las plataformas NDR de OT especialmente diseñadas crean una línea base de comportamiento de cada activo en la red, con qué se comunica, qué comandos emite normalmente y cómo se ve un patrón de funcionamiento seguro, y señalan las desviaciones de esa línea base en tiempo real, sin requerir un escaneo intrusivo que podría interrumpir sistemas de control sensibles.
Capacidad | Monitoreo tradicional centrado en TI | Detección y respuesta de red OT especialmente diseñada |
Conocimiento de protocolos | Solo entiende protocolos comunes de TI | Analiza protocolos industriales (Modbus, DNP3, EtherNet/IP, OPC-UA y otros) |
Método de descubrimiento | Escaneo activo, a menudo disruptivo | Monitoreo de tráfico pasivo y no intrusivo seguro para dispositivos heredados |
Lógica de detección | Coincidencia de firmas y CVE | Establecimiento de líneas base de comportamiento de activos, comandos y lógica de procesos |
Visibilidad de activos | Limitada a endpoints de TI en red | Inventario completo de PLCs, RTUs, HMIs, sensores y estaciones de trabajo de ingeniería |
Velocidad de respuesta | Clasificación manual, de horas a días | Clasificación automatizada y contención orquestada en minutos |
Alineación con la seguridad | No diseñado pensando en la seguridad del proceso | Acciones de respuesta calibradas según el impacto operativo y de seguridad |
Tabla 1: Diferencias entre la detección de redes OT especialmente diseñada y las herramientas de monitoreo de TI genéricas.
Esta base conductual y consciente de los protocolos es lo que hace que la automatización sea confiable en un contexto de OT. Un sistema automatizado solo puede tomar medidas seguras cuando realmente comprende cómo se ve lo "normal" en esa red específica, razón por la cual acoplar una herramienta de TI genérica a una línea de producción a menudo causa más daño que beneficio.
Automatización del ciclo de vida de respuesta ante incidentes
La automatización en la respuesta ante incidentes de OT no consiste en eliminar a los humanos del proceso, sino en eliminar el retraso entre la detección y la primera acción de contención segura, de modo que los expertos humanos dediquen su tiempo a tomar decisiones críticas en lugar de buscar datos brutos. Un flujo de trabajo automatizado maduro generalmente pasa por seis etapas, cada una alimentando a la siguiente sin esperar a que una persona lo active manualmente.
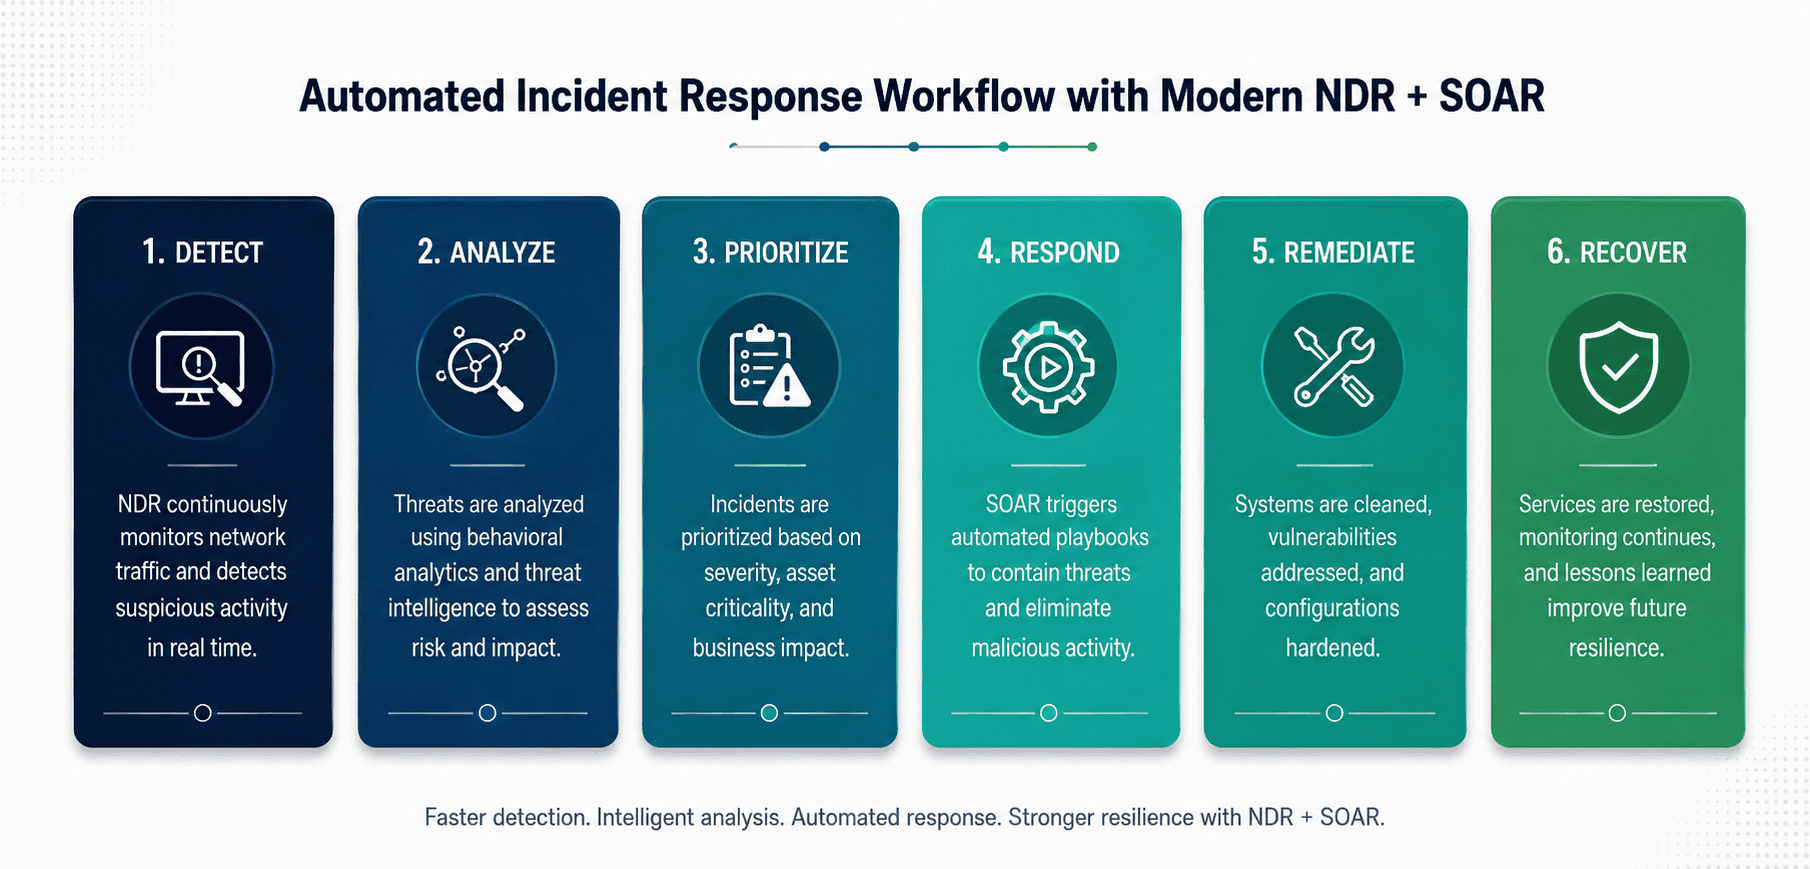
Figura 1: Un flujo moderno de respuesta automatizada ante incidentes que conecta sensores NDR conscientes de OT con orquestación impulsada por SOAR.
1. Detectar
Los sensores ubicados en intersecciones clave de la red comparan continuamente el tráfico en vivo con la línea base de comportamiento establecida, señalando anomalías como una estación de trabajo de ingeniería que de repente emite comandos de escritura a un controlador con el que nunca antes se había comunicado.
2. Enriquecer
Las alertas en bruto se complementan automáticamente con el contexto del activo, tipo de dispositivo, versión de firmware, criticidad, ubicación física y se contrastan con la inteligencia de amenazas actual, transformando un simple evento de red en un incidente completamente contextualizado.
3. Clasificar (Triage)
La puntuación automatizada evalúa la alerta enriquecida frente al impacto empresarial y de seguridad, separando una anomalía de mantenimiento de rutina de una amenaza creíble para un sistema instrumentado de seguridad, de modo que los analistas se concentren solo en lo que realmente importa.
4. Orquestar
Para las alertas que superan un umbral de riesgo definido, los playbooks preaprobados se ejecutan automáticamente, reforzando las reglas del firewall, revocando una sesión remota sospechosa o moviendo un dispositivo a una VLAN restringida, sin esperar a que un humano escriba el primer comando.
5. Contener
Las acciones de contención se limitan con precisión al segmento afectado, por lo que una HMI comprometida puede aislarse sin interrumpir los controladores de seguridad o las líneas de producción que operan a su alrededor, preservando el tiempo de actividad al tiempo que se elimina el alcance de la amenaza.
6. Reportar
Cada acción, marca de tiempo y punto de decisión se registra automáticamente en una línea de tiempo forense, lista para el SOC, reguladores, aseguradoras y el liderazgo ejecutivo, convirtiendo lo que solían ser días de reconstrucción posterior a la acción en un registro disponible al instante.
Segmentación de red: La base que hace segura la automatización
Ninguna de las automatizaciones descritas anteriormente es segura de implementar sin una red deliberadamente segmentada por debajo. La segmentación es lo que permite que un playbook automatizado aísle una zona comprometida con precisión quirúrgica en lugar de provocar un cierre en toda la planta por precaución. La mayoría de los entornos industriales todavía se asemejan a grandes rasgos a la Arquitectura de Referencia de la Empresa Purdue, y cada capa de ese modelo representa tanto un límite funcional como un límite de seguridad que debe aplicarse, no solo documentarse.
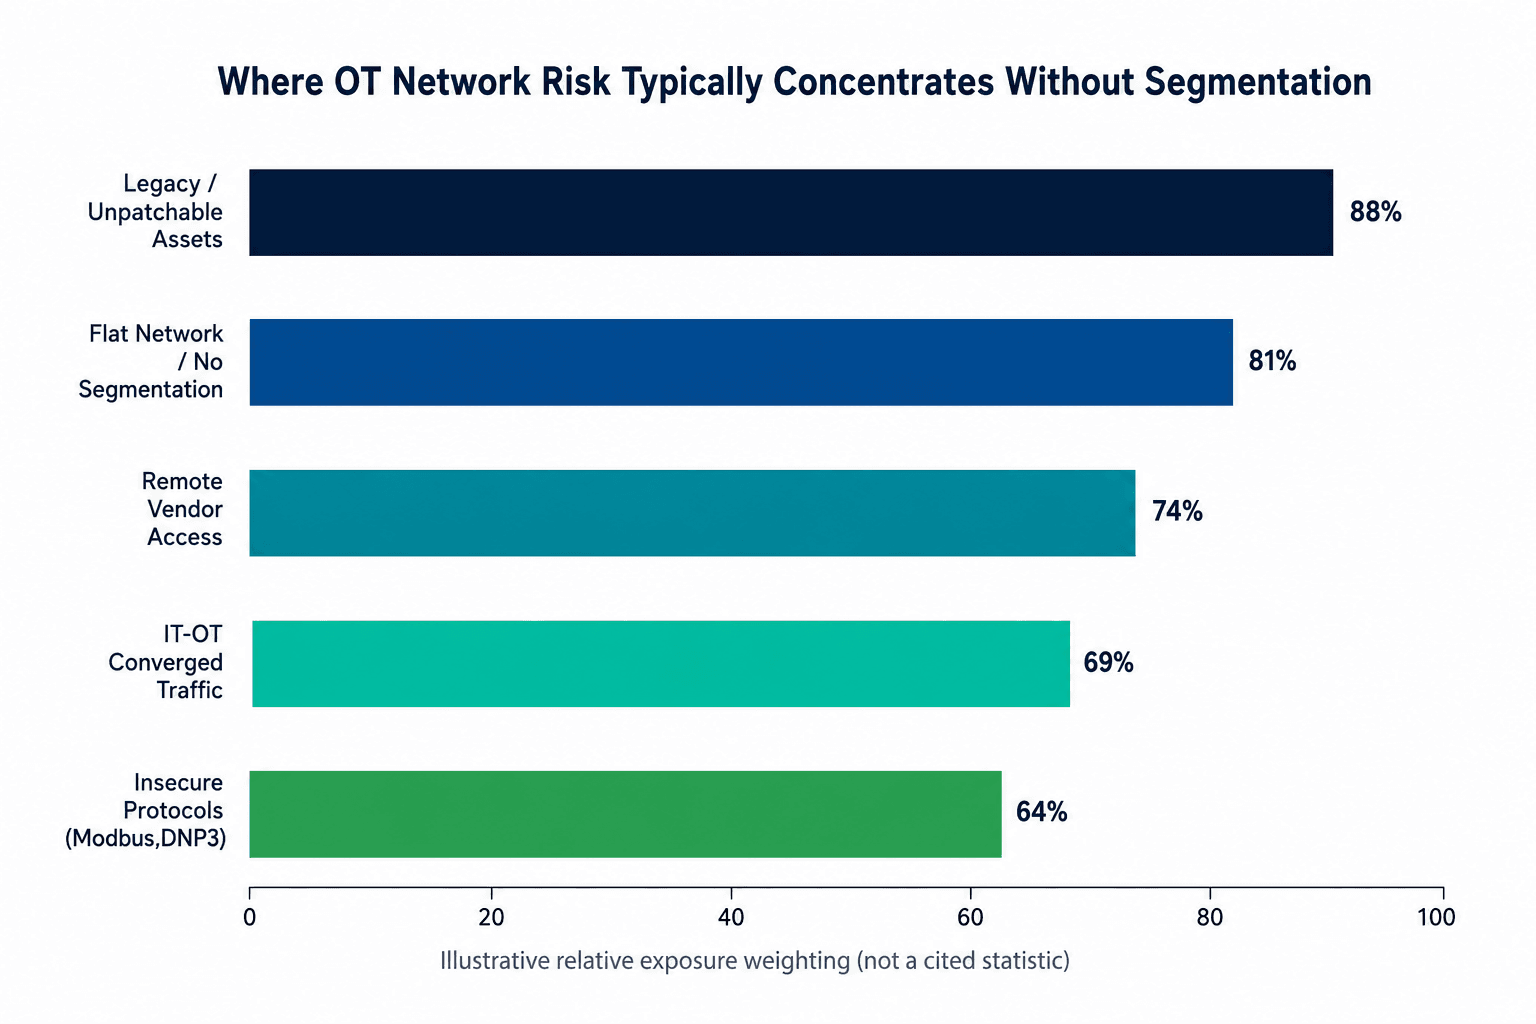
Figura 2: Aplicación de la verificación de confianza cero en cada límite del modelo Purdue, desde la TI empresarial hasta los dispositivos de campo.
Nivel Purdue | Qué vive ahí | Prioridad de segmentación |
Nivel 5, TI empresarial | Aplicaciones corporativas, correo electrónico, servicios en la nube | Límite estricto con OT; sin acceso directo al plano de control |
Nivel 4, Planificación empresarial | ERP, logística empresarial, sistemas de reporte | Flujos de datos unidireccionales hacia OT donde sea posible |
Nivel 3, Operaciones y MES | Ejecución de manufactura, historiales, servidores de parches | Intermediar todo el tráfico a través de una DMZ monitoreada |
DMZ | Servidores de salto, historiales replicados, pasarelas de acceso remoto | Punto de aplicación de confianza cero; cada sesión verificada |
Nivel 2, Control de supervisión | SCADA, HMI, estaciones de trabajo de ingeniería | Microsegmentado por línea de producción o celda |
Nivel 0-1, Dispositivos de campo | PLCs, RTUs, sensores, actuadores | Grupos de dispositivos aislados con acceso este-oeste estrechamente delimitado |
Tabla 2: Prioridades de segmentación asignadas a cada capa del modelo de referencia Purdue.
Las organizaciones que se recuperan más rápido de un incidente de seguridad de OT casi nunca son las que evitaron todos los ataques, sino aquellas cuya arquitectura de red limitó físicamente qué tanto podía moverse un atacante una vez dentro. La segmentación convierte una emergencia potencial en toda la planta en un evento contenido en una sola celda que las herramientas automatizadas pueden neutralizar en minutos.
Aplicación de principios de confianza cero dentro de entornos OT
A menudo se habla de la confianza cero como un concepto de TI, pero sus tres principios fundamentales se trasladan directamente al mundo industrial, con algunas adaptaciones importantes para las realidades de los equipos heredados y las operaciones continuas.
Verificar explícitamente: cada sesión, ya sea de la herramienta de acceso remoto de un proveedor, una computadora portátil de ingeniería o un historial que extrae datos, se autentica y autoriza según la identidad y el contexto, no simplemente porque se origina dentro de la red de la planta.
Aplicar el privilegio mínimo: un operador, ingeniero o integrador externo recibe acceso delimitado exactamente a los sistemas y funciones que requiere su rol, nada más, lo que limita drásticamente lo que una credencial comprometida puede hacer en realidad.
Asumir la brecha: la arquitectura y el monitoreo se diseñan bajo el supuesto de que un atacante eventualmente logrará un punto de apoyo en algún lugar, por lo que la prioridad cambia de evitar cada intrusión a limitar el radio de impacto y detectar el movimiento lateral de inmediato.
Aplicada correctamente, la confianza cero no significa agregar fricción a cada acción del operador en el piso de la planta. Significa eliminar la confianza implícita en la que las redes OT planas y heredadas han confiado durante décadas (la suposición de que cualquier cosa que ya esté dentro del perímetro es segura) y reemplazarla con una verificación contextual continua en los puntos que más importan: la DMZ, las pasarelas de acceso remoto y los límites entre las celdas de producción.
Riesgos, desafíos y perspectivas de la industria
Incluso las organizaciones que reconocen la necesidad de una respuesta automatizada y de la segmentación se topan con obstáculos predecibles cuando intentan implementarlas. Comprender estos desafíos de antemano es lo que distingue una implementación que fortalece las operaciones de una que las interrumpe.
Activos heredados y no parcheables: muchos dispositivos de campo ejecutan software que no se puede actualizar sin la intervención del proveedor o una ventana de inactividad total, por lo que la segmentación y el monitoreo a menudo tienen que compensar las vulnerabilidades que no se pueden parchear directamente.
Redes planas y no documentadas: las plantas construidas o expandidas a lo largo de décadas con frecuencia tienen mucha más conectividad este-oeste de lo que se cree, y un ejercicio completo de descubrimiento de activos y tráfico suele ser el primer paso antes de que se pueda diseñar la segmentación.
Acceso remoto de terceros y proveedores: los contratos de mantenimiento a menudo requieren que ingenieros externos accedan a controladores específicos y, sin un acceso delimitado, con límite de tiempo y monitoreado, esa vía se convierte en una de las rutas más comunes que utilizan los atacantes para ingresar a una red OT.
Tráfico de TI-OT convergente: la misma conectividad que permite el mantenimiento predictivo y el análisis en tiempo real también crea un puente que los atacantes pueden utilizar para pasar de una computadora portátil de oficina comprometida al piso de la planta.
Protocolos inseguros por diseño: muchos protocolos industriales se crearon hace décadas sin pensar en la autenticación o el cifrado, por lo que el monitoreo y la segmentación deben soportar la carga de seguridad que el protocolo en sí no puede llevar.
Brechas de habilidades y personal: los equipos de seguridad capacitados en herramientas de TI a menudo carecen del conocimiento de los procesos de OT necesario para juzgar si una acción de contención es segura, que es exactamente la brecha que la automatización y los playbooks bien diseñados están destinados a cerrar.
Ninguno de estos desafíos es motivo para retrasar la acción. Son los problemas específicos que un programa de automatización y segmentación por fases está diseñado para resolver, una zona de producción a la vez, sin exigir una renovación de red disruptiva y de golpe.
El impulso regulatorio lo está volviendo no negociable
Más allá del riesgo operativo, el panorama regulatorio en torno a la ciberseguridad industrial ha cambiado decisivamente hacia la exigencia de las capacidades descritas en este artículo. Estándares como el IEC 62443 exigen explícitamente la segmentación de la red en zonas y conductos de seguridad como un control fundamental para los sistemas de automatización industrial. En América del Norte, los requisitos de NERC CIP imponen obligaciones específicas a los operadores de sistemas eléctricos de gran potencia en torno a los perímetros de seguridad electrónica y la planificación de la respuesta ante incidentes. Los operadores de ductos y transporte se han enfrentado a nuevas directivas que exigen una segmentación de red documentada y un monitoreo continuo tras incidentes de alto perfil. Y un número creciente de jurisdicciones espera ahora la divulgación oportuna de brechas de seguridad para incidentes que afecten a la infraestructura crítica, lo cual es mucho más fácil de cumplir cuando las herramientas automatizadas ya producen una línea de tiempo forense completa.
Ninguno de estos marcos exige un proveedor o producto específico, pero casi todos convergen en las mismas expectativas subyacentes: conozca sus activos, segmente su red, monitoree continuamente y demuestre una capacidad de respuesta ante incidentes probada. Las organizaciones que construyen proactivamente hacia estos principios encuentran que las auditorías de cumplimiento son mucho menos disruptivas que aquellas que intentan adaptar documentación a una red que nadie ha mapeado por completo.
Recomendaciones prácticas y mejores prácticas
Las organizaciones que modernizan con éxito su capacidad de respuesta ante incidentes tienden a seguir una secuencia similar, priorizando la visibilidad antes que la automatización y la segmentación antes que la aplicación de políticas.
Comience con un inventario completo de activos y tráfico: no puede segmentar, establecer líneas base ni automatizar una respuesta para un dispositivo que su equipo no sabe que existe.
Establezca un monitoreo pasivo antes que cualquier otra cosa: el NDR no intrusivo y consciente de OT debería estar funcionando y construyendo una línea base de comportamiento mucho antes de que se habilite cualquier acción de contención automatizada.
Segmente de forma incremental, por zona de producción: en lugar de intentar un rediseño de toda la planta, aísle primero las celdas de mayor riesgo o valor y expándase hacia afuera a medida que aumente la confianza.
Construya una DMZ que realmente aplique la confianza cero: cada flujo de datos entre TI y OT, incluida la réplica de historiales y el acceso remoto, debe pasar a través de un intermediario monitoreado en lugar de una conexión directa.
Defina playbooks con operaciones, no solo con seguridad: las acciones de contención deben ser revisadas y aprobadas por ingenieros de planta que entiendan las implicaciones de seguridad y de proceso antes de automatizarlas.
Limite el tiempo y monitoree todo acceso de terceros: las sesiones de proveedores e integradores deben estar delimitadas a sistemas específicos, registrarse por completo y expirar automáticamente cuando finalice la ventana de mantenimiento.
Pruebe los playbooks de respuesta con regularidad: los ejercicios de simulacro e incidentes simulados mantienen listos tanto a la automatización como al equipo humano para un evento real, y sacan a la luz las brechas antes de que lo haga un atacante.
Reporte métricas que importen al liderazgo: el tiempo promedio de detección, el tiempo promedio de contención y la cobertura de segmentación brindan a los ejecutivos una visión clara y lista para la junta directiva sobre la mejora de la resiliencia a lo largo del tiempo.
La mayoría de los programas exitosos se desarrollan en tres fases deliberadas en lugar de un único proyecto disruptivo, lo que mantiene bajo el riesgo operativo mientras ofrece un progreso medible en los primeros meses.
Fase | Enfoque principal | Resultado típico |
Fase 1, Visibilidad | Descubrimiento de activos, monitoreo pasivo de tráfico, comportamiento de línea base | Un mapa completo y preciso de lo que realmente hay en la red |
Fase 2, Segmentación | Aplicación de DMZ, diseño de zonas y conductos, controles de acceso remoto | Radio de impacto contenido y límites de privilegios mínimos aplicados |
Fase 3, Automatización | Playbooks de SOAR, contención orquestada, pruebas continuas | Tiempo de detección a contención a nivel de minutos con un esfuerzo manual mínimo |
Tabla 4: Un enfoque por fases que construye la automatización sobre una base de visibilidad y segmentación.
Preguntas frecuentes
¿Es posible la segmentación de red sin interrumpir la producción en vivo?
Sí, cuando se planifica como una implementación por fases que comienza con el descubrimiento pasivo. Los proyectos de segmentación que fallan casi siempre son los que saltan directamente a la aplicación de políticas sin comprender primero los patrones de tráfico reales; un enfoque cuidadoso, zona por zona, evita interrupciones imprevistas.
¿Puede la respuesta automatizada detener accidentalmente un proceso crítico para la seguridad?
Solo si los playbooks están mal diseñados. La automatización bien construida se limita de manera precisa a las acciones de contención en la capa de red, como aislar un puerto de switch o restringir una VLAN, por ejemplo, y se desarrolla conjuntamente con ingenieros de procesos para que nunca afecte directamente a los sistemas instrumentados de seguridad.
¿En qué se diferencia el NDR enfocado en OT de un firewall de TI o una herramienta antivirus?
Los firewalls y las herramientas antivirus controlan el acceso y detectan archivos maliciosos conocidos; no entienden los protocolos industriales ni el contexto de comportamiento. El NDR de OT está diseñado específicamente para observar cómo se comunican realmente los dispositivos y señalar desviaciones de ese patrón, que es donde la mayoría de las intrusiones reales de ICS eventualmente se revelan.
¿Qué debe esperar un gerente de planta de una evaluación inicial?
Una evaluación creíble comienza con el descubrimiento pasivo de la red, no con un escaneo intrusivo, y debe producir un inventario de activos claro, un análisis de brechas de segmentación y un conjunto priorizado de recomendaciones vinculadas al riesgo operativo real, no una lista de verificación genérica.
Cómo Shieldworkz apoya a las organizaciones
Shieldworkz trabaja junto a los operadores industriales, los equipos de ingeniería de planta y los líderes de seguridad para crear una respuesta ante incidentes y una arquitectura de red que se adapte a las realidades de los entornos de producción en vivo, no una plantilla genérica tomada de la TI empresarial.
Descubrimiento integral de activos de OT y mapeo de red, entregados a través de métodos pasivos y no intrusivos que nunca ponen en riesgo la continuidad de los sistemas de control sensibles.
Detección de red especialmente diseñada y ajustada a los protocolos industriales, lo que brinda a los equipos de seguridad una línea base de comportamiento en lugar de una avalancha de alertas irrelevantes de estilo TI.
Diseño de segmentación de confianza cero alineado con el modelo Purdue y adaptado a las zonas de producción, proveedores y requisitos de seguridad específicos de cada instalación.
Playbooks de respuesta automatizada ante incidentes codesarrollados con ingenieros de planta y de procesos, de modo que cada acción de contención respete las restricciones operativas y de seguridad.
Monitoreo continuo, inteligencia de amenazas y soporte de respuesta ante incidentes por parte de un equipo con dominio tanto en ciberseguridad como en operaciones industriales.
Informes a nivel ejecutivo y de junta directiva que traducen el riesgo técnico en términos operativos y financieros claros para una toma de decisiones informada.
El objetivo es directo: reducir el tiempo entre la primera señal de compromiso y la contención total, sin agregar riesgo operativo ni complejidad innecesaria a entornos donde el tiempo de actividad y la seguridad son lo primero.
Conclusión
La organizaciones mejor posicionadas para resistir el próximo gran incidente cibernético industrial no serán las que nunca sean atacadas; eventualmente, todos los entornos industriales conectados lo serán. Serán aquellas que detecten una intrusión en minutos en lugar de meses, la contengan dentro de una sola zona segmentada en lugar de toda una planta, y lo hagan todo sin una sola parada de producción no planificada. Ese resultado no es producto de una sola herramienta. Es el resultado de una detección de red especialmente diseñada, una segmentación disciplinada de confianza cero y una respuesta automatizada que funcionan juntas como un sistema coordinado.
Construir ese sistema requiere una planificación deliberada, un conocimiento profundo de los procesos de OT y un socio que entienda que una sala de control no es un centro de datos. Cuanto antes se establezca esa base, menor será la ventana de oportunidad para un atacante y con mayor confianza podrá seguir operando un equipo de operaciones.
¿Listo para ver cuál es el estado real de su red OT?
Reserve una consulta gratuita y sin compromiso con el equipo de ciberseguridad industrial de Shieldworkz. Analizaremos su arquitectura de red actual, discutiremos los pasos prácticos iniciales hacia la segmentación y la respuesta automatizada, y responderemos a las preguntas que su junta directiva ya se está haciendo.
Reserve una consulta gratuita con nuestros expertos
Recursos adicionales:
Guía completa de detección y respuesta de red (NDR) en 2026 aquí
Lista de verificación de preparación para el monitoreo de seguridad de la red interna NERC CIP-015 para empresas de energía eléctrica aquí
Guía fundamental de OT SOC aquí
Servicio de SOC administrado aquí
Asesoría de inteligencia de amenazas cibernéticas de OT - Medio Oriente aquí
Directiva NIS2: Lograr el cumplimiento de NIS2 a través de IEC 62443 aquí
¿Qué son los medios extraíbles? Riesgos, políticas y soluciones de seguridad OT industrial aquí
Plantilla gratuita de política de medios extraíbles para equipos de OT y TI aquí
Recibe semanalmente
Recursos y Noticias
Vea cómo nuestras soluciones de seguridad de OT líderes en la industria abordan los desafíos de seguridad críticos
También te puede interesar

What the French supermarket cyberattack reveals about OT security
Prayukth K V

Inside the Albert Heijn cyber incident: Investigating the attack, the IT/OT exposure, and the risks to critical operations
Team Shieldworkz

50°C by cyberattack? Inside France’s supermarket refrigeration crisis
Prayukth K V

Automating IEC 62443 Compliance Assessments Without Losing Expert Control
Team Shieldworkz

Investigative cyber threat intelligence report: Daiichi Kosho supply-chain data exposure
Prayukth K V

How AI Is Changing IEC 62443 Assessments
Team Shieldworkz







