



Equipo Shieldworkz
El ransomware dirigido a la Tecnología de Operación (OT) y a los Sistemas de Control Industrial (ICS) representa una emergencia operativa inmediata. A diferencia de un incidente de TI empresarial en el que los servidores cifrados se traducen en pérdida de datos y tiempo de inactividad comercial, el ransomware de OT amenaza el control físico de los procesos, la seguridad ambiental, la vida del personal y la disponibilidad de la infraestructura crítica.
Cuando el ransomware se manifiesta cerca o dentro de entornos de control industrial, los manuales de estrategia estándar de TI de la empresa —específicamente el aislamiento automatizado de endpoints y las desconexiones generales de red— pueden provocar paradas repentinas e inseguras de los procesos. Este artículo proporciona una guía de respuesta ante incidentes autorizada diseñada específicamente para CISO, directores de seguridad de OT, operadores de salas de control y equipos de SOC de OT.
El contexto de respuesta ante incidentes específico de OT
La respuesta ante incidentes de TI empresarial prioriza la confidencialidad de los datos, la contención de la red y la remediación rápida de los endpoints. Los sistemas de control industrial priorizan la seguridad del personal, la seguridad de los procesos, la disponibilidad operativa y la integridad de los procesos.
Las medidas de contención indiscriminadas en OT conllevan un riesgo operativo severo. Las paradas no planificadas pueden provocar sobrepresión, desbocamientos térmicos, liberaciones de productos químicos peligrosos, daños en equipos pesados o inestabilidad en la red eléctrica regional.
Por qué la respuesta al ransomware de OT difiere de la de TI empresarial
La seguridad y la estabilidad son lo primero: El objetivo principal de la respuesta de OT es contener la ciberamenaza manteniendo al mismo tiempo un estado operativo seguro. Detener el malware no puede hacerse a expensas de la seguridad del proceso.
Dependencias de procesos y pérdida de visibilidad: Cortar a ciegas el acceso a la red de las interfaces hombre-máquina (HMI), las estaciones de trabajo de ingeniería o los servidores de control de supervisión y adquisición de datos (SCADA) priva a los operadores de la sala de control de visibilidad y capacidades de anulación manual.
Infraestructura heredada y protocolos heredados: Los entornos de OT ejecutan con frecuencia sistemas operativos sin soporte junto con protocolos industriales no autenticados y no cifrados (por ejemplo, Modbus TCP, DNP3, EtherNet/IP). Estos protocolos carecen de controles de seguridad nativos básicos como el cifrado o la validación de carga útil.
Movimiento lateral de TI a OT: El ransomware rara vez se origina en dispositivos de campo de Nivel 1 (PLC/RTU). Por lo general, vulnera la TI empresarial (Nivel 4), atraviesa la DMZ de OT (Nivel 3.5) y se dirige a los componentes SCADA, el software de ingeniería y los historiadores (Nivel 3/2).
La respuesta moderna de OT debe alinearse con NIST SP 800-82 Rev. 3 (Guide to Operational Technology Security), NIST SP 800-61 Rev. 3 (Incident Response Recommendations and Considerations), las pautas de manejo de incidentes de ICS de CISA y la norma ISA/IEC 62443. Desconectar los sistemas a ciegas viola el principio operativo de CISA de que la contención nunca debe degradar las funciones instrumentadas de seguridad (SIF) o los lazos de control críticos.
Los 7 pasos clave para la respuesta ante incidentes
Paso 1: Declarar y clasificar el incidente
Determine rápidamente el radio de impacto y establezca si la amenaza es estrictamente un evento de TI, un riesgo adyacente a OT o un compromiso activo del proceso físico.
Qué hacer: Declarar formalmente un ciberincidente de OT, establecer una Estructura de Comando de Incidentes que integre tanto la Seguridad de TI como las Operaciones de la Planta, y asignar un nivel de gravedad operativa.
Por qué es importante: Evita que los equipos de seguridad de TI tomen acciones de contención unilaterales que interrumpan las operaciones de la planta sin el conocimiento de la sala de control.
Quién debe hacerlo: Comandante de Incidentes, CISO, Director de Seguridad de OT, Gerente Líder de Operaciones de Planta.
Qué NO hacer: No intente remediar silenciosamente infecciones de ransomware activas en la infraestructura de Nivel 3 sin declarar un incidente y notificar a los operadores de la planta.
Consideraciones de OT: Verifique si el ransomware cifra los archivos del sistema operativo subyacente o simplemente interrumpe el acceso a los ejecutables de la interfaz hombre-máquina de SCADA.
Evidencia/registros a preservar: Registros de firewalls (DMZ de TI/OT), registros de Active Directory, informes iniciales de usuarios, capturas de alertas de detección de endpoints, volcados de memoria de hosts de salto (jump hosts) afectados.
Puntos de decisión: ¿El ransomware está confinado a los sistemas empresariales de Nivel 4, a la DMZ de Nivel 3.5, o ha llegado a las redes de control de Nivel 3/2?
Errores comunes: Clasificar un incidente puramente como un "problema de TI" cuando el Active Directory empresarial (que administra los hosts de salto de OT) está comprometido.
Lista de verificación para el triaje inicial:
[ ] Confirmar los síntomas reportados (por ejemplo, extensiones .locked, notas de rescate, caídas de aplicaciones HMI).
[ ] Determinar si los sistemas instrumentados de seguridad (SIS) o los solucionadores de lógica de seguridad permanecen en línea y sin comprometerse.
[ ] Verificar la visibilidad del operador en todos los lazos primarios de los procesos físicos.
[ ] Convocar a una llamada conjunta de Comando de Incidentes de TI/OT dentro de los 15 minutos posteriores a la sospecha de detección.
Paso 2: Proteger la seguridad y estabilizar el proceso industrial
Determine el estado de seguridad operativa antes de ejecutar comandos técnicos de contención o forenses.
Qué hacer: Involucrar a los operadores de la sala de control para evaluar si la telemetría en tiempo real, el monitoreo de alarmas, las capacidades de control remoto y los sistemas de seguridad siguen siendo funcionales y confiables.
Por qué es importante: Si los operadores pierden la visibilidad de la HMI o el control del proceso, la planta debe pasar a un estado seguro manual controlado o ejecutar una parada de emergencia (ESD) ordenada.
Quién debe hacerlo: Supervisor de Turno, Operadores de la Sala de Control, Ingenieros de Automatización de Planta.
Qué NO hacer: No emita comandos de reinicio masivo ni apague los servidores de ingeniería mientras los operadores dependan de ellos para monitorear parámetros críticos del proceso.
Consideraciones de OT: Los equipos de respuesta a ciberincidentes deben delegar en los operadores de planta certificados en lo que respecta a la seguridad física y los procedimientos de parada.
Evidencia/registros a preservar: Registros de historial de alarmas, registros de acciones del operador, datos de tendencias del historiador, registradores de eventos de seguridad del proceso.
Puntos de decisión: ¿Pueden los operadores mantener un estado seguro de forma manual si falla todo el software SCADA de Nivel 3? Si no, iniciar una parada controlada y segura del proceso.
Errores comunes: Tratar la pérdida de actualizaciones de la pantalla de la HMI como un simple fallo de software en lugar de una pérdida de visibilidad inducida por un ciberataque.
Lista de verificación de seguridad del proceso:
[ ] Verificar el funcionamiento operativo de los Sistemas Instrumentados de Seguridad (SIS) de forma independiente de los sistemas de control de procesos básicos (BPCS).
[ ] Confirmar que los controles de anulación manual para válvulas, disyuntores y bombas críticas estén operativos.
[ ] Asegurar que los canales de comunicación auxiliares (radios, líneas fijas) entre la sala de control y los técnicos de campo estén activos.
Paso 3: Contener el ataque sin interrumpir a ciegas la OT
Aplique contención de red e identidad de forma dirigida para evitar la propagación de ransomware sin cortar las comunicaciones de control críticas.
Qué hacer: Cortar las conexiones de límite no esenciales de TI a OT, rescindir el acceso remoto de proveedores (VPN, jump boxes), restringir las cuentas de servicio comprometidas y bloquear las direcciones IP de C2 maliciosas en el firewall de la DMZ de OT.
Por qué es importante: La contención evita el movimiento lateral desde las redes de TI empresariales hacia las redes operativas de Nivel 3, al tiempo que permite que la comunicación interna de OT (de PLC a HMI) siga funcionando.
Quién debe hacerlo: Ingenieros de Redes de OT, Especialistas en Firewalls/Seguridad de Redes, Analistas del SOC de OT.
Qué NO hacer: No ejecute paradas generales de puertos de red a nivel de switch central de OT ni deshabilite los controladores de dominio internos de OT sin evaluar el impacto en el proceso.
Consideraciones de OT: Desconectar un controlador de dominio de OT puede hacer que las HMI heredadas fallen en la autenticación, perdiendo el acceso a la interfaz de control de forma instantánea.
Evidencia/registros a preservar: Registros de cambios en firewalls, registros de sesiones activas de VPN, archivos PCAP de endpoints aislados, cambios de privilegios en Active Directory.
Puntos de decisión: ¿Cuándo aislar la TI de la OT? Aislar inmediatamente en el firewall de la DMZ de OT cuando el Active Directory empresarial esté comprometido o cuando el ransomware se esté propagando activamente por el Nivel 4.
Errores comunes: Desconectar enlaces de red que transportan datos vitales de sincronización de procesos o enclavamientos de seguridad entre unidades físicas.
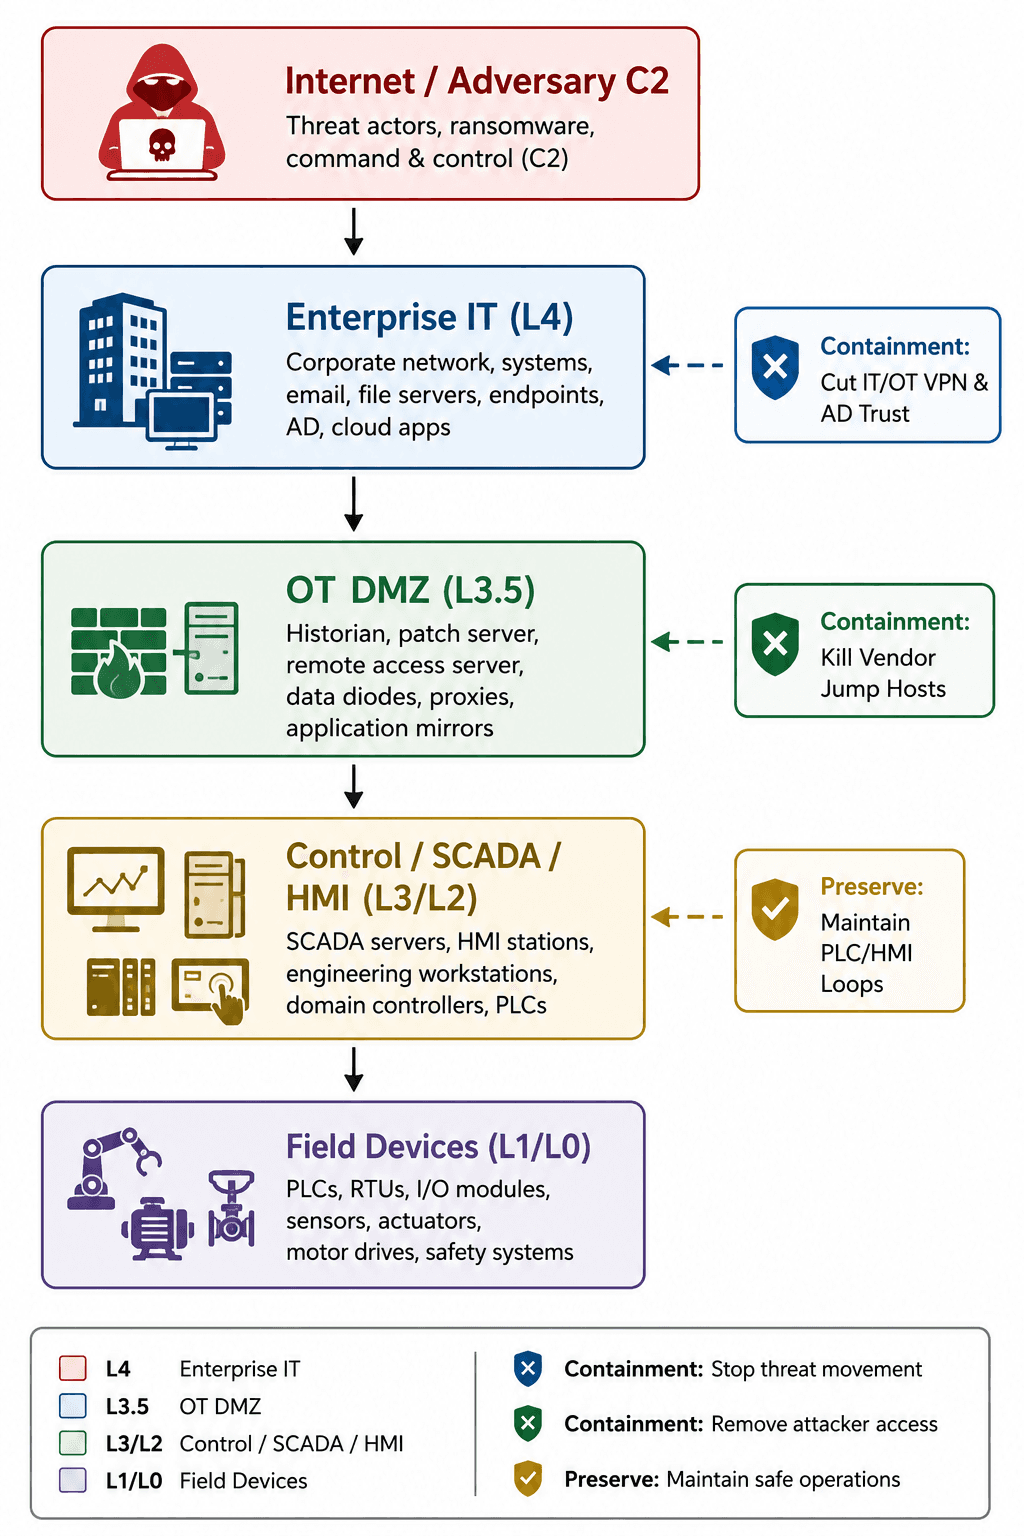
Paso 4: Realizar triaje y preservación de evidencia enfocados en OT
Localice la huella del adversario en la infraestructura específica de OT mientras preserva la evidencia volátil de manera segura.
Qué hacer: Recopilar memoria volátil, realizar triaje de artefactos forenses (MFT, registros de eventos, shimcache), examinar archivos de proyectos de ingeniería y revisar las líneas base de configuración lógica de PLC/DCS.
Por qué es importante: Los adversarios a menudo despliegan ransomware como una cobertura destructiva para objetivos secundarios, como modificar parámetros de seguridad, alterar la lógica de los PLC o robar documentación de procesos patentada.
Quién debe hacerlo: Especialistas Líderes en Análisis Forense Digital y Respuesta a Incidentes (DFIR) de OT, Ingenieros de Automatización.
Qué NO hacer: No ejecute escáneres de vulnerabilidades invasivos y de alto volumen (por ejemplo, barridos activos con Nmap) en redes de OT heredadas, ya que esto puede bloquear los PLC heredados.
Consideraciones de OT: Priorice la recopilación de datos de los servidores de salto, las estaciones de trabajo de ingeniería (EWS) y los historiadores, que sirven como puntos de pivote clave para los atacantes.
Evidencia/registros a preservar: Capturas de RAM, registros de eventos del sistema (System.evtx, Security.evtx), capturas de flujo de red, archivos de proyectos de PLC (.ACD, .ap13, etc.), bases de datos de historiadores.
Puntos de decisión: ¿Ha modificado el adversario la lógica de programación del PLC/DCS, o la amenaza está aislada a los entornos de sistemas operativos Windows/Linux subyacentes?
Errores comunes: Volver a instalar la imagen de una HMI infectada antes de extraer los artefactos de la RAM o del disco, destruyendo la evidencia necesaria para identificar la causa raíz.
Lista de verificación de triaje de OT
[ ] Auditar las cuentas de Active Directory en busca de usuarios administradores no autorizados de reciente creación.
[ ] Verificar las sumas de comprobación de los archivos de proyectos de ingeniería con las líneas base fuera de línea conocidas.
[ ] Extraer y preservar la memoria y los registros de los hosts de salto e historiadores afectados.
[ ] Revisar los registros de acceso remoto externo (RDP, TeamViewer, AnyDesk, SSH) en busca de accesos anómalos.
Paso 5: Erradicar la amenaza y validar el entorno
Elimine la persistencia de los adversarios, las herramientas maliciosas y las credenciales comprometidas en los dominios corporativos y operativos.
Qué hacer: Purgar cuentas de usuario no autorizadas, restablecer todas las credenciales de dominio empresariales y de OT, revocar claves de API comprometidas, reconstruir los endpoints afectados a partir de imágenes verificadas y parchear las vulnerabilidades explotadas.
Por qué es importante: Los binarios de ransomware son simplemente la carga útil. Dejar puertas traseras activas, tareas programadas o claves SSH comprometidas permite a los atacantes volver a cifrar los sistemas días después de la restauración inicial.
Quién debe hacerlo: Ingenieros de Seguridad de OT, Administradores de Sistemas, Especialistas en DFIR.
Qué NO hacer: No asuma que eliminar el archivo binario ejecutable (.exe) del ransomware completa la erradicación.
Consideraciones de OT: El restablecimiento de credenciales debe coordinarse con cuidado. Cambiar las contraseñas en cuentas de servicio vinculadas a conexiones codificadas de bases de datos SCADA/DCS puede provocar la caída de los servicios de las aplicaciones.
Evidencia/registros a preservar: Resultados de escaneos de vulnerabilidades posteriores a la limpieza, auditorías de cambios de configuración, hashes de validación de línea base.
Puntos de decisión: ¿Se han identificado y purgado todos los vectores de persistencia en los entornos de TI y OT antes de comenzar la restauración completa del sistema?
Errores comunes: No restablecer las contraseñas de administrador local en HMI heredadas que no están unidas al dominio.
Lista de verificación de validación de erradicación:
[ ] Completar el restablecimiento del 100 % de las contraseñas para todas las cuentas de dominio de OT, cuentas de servicio y cuentas de administrador local.
[ ] Terminar y volver a emitir todos los certificados de acceso remoto y tokens de autenticación de múltiples factores (MFA).
[ ] Eliminar todos los mecanismos de persistencia (servicios no autorizados, tareas programadas, claves de ejecución del registro).
[ ] Validar las firmas de firmware de PLC/DCS y verificar el código de lógica de escalera (ladder logic) contra copias de referencia limpias y fuera de línea.
Paso 6: Recuperar los sistemas de OT de forma segura
Reconstruya y restaure las aplicaciones de OT, las bases de datos y los nodos de control de manera sistemática utilizando respaldos limpios y verificados.
Qué hacer: Restaurar imágenes de sistema y bases de datos de procesos a partir de respaldos verificados y aislados (air-gapped). Validar la lógica, realizar pruebas fuera de línea funcionales y ejecutar una reconexión controlada y por fases.
Por qué es importante: Restaurar un respaldo no validado puede reintroducir persistencia de malware inactivo o configuraciones de procesos corruptas en el entorno de control activo.
Quién debe hacerlo: Ingenieros de Automatización, Administradores de Sistemas, Equipo de Operaciones de Planta.
Qué NO hacer: No reconecte las redes de OT restauradas al entorno de TI de la empresa hasta que este último esté completamente saneado y validado.
Consideraciones de OT: Valide que las bases de datos del historiador y los archivos de proyecto SCADA restaurados coincidan con los parámetros operativos anteriores al incidente antes de poner los sistemas en control.
Evidencia/registros a preservar: Registros de validación de restauración, listas de verificación previas a la puesta en marcha, documentación de aprobación operativa.
Puntos de decisión: ¿El respaldo fuera de línea está limpio, sin corrupción y verificado como seguro para su despliegue en producción?
Errores comunes: Iniciar máquinas virtuales restauradas conectadas a redes de producción activas sin aislarlas para una verificación de seguridad inicial.
Paso 7: Realizar análisis posterior al incidente y fortalecer la resiliencia
Analice la causa raíz, identifique brechas estructurales y fortalezca las defensas de OT contra futuros ataques destructivos.
Qué hacer: Realizar un Análisis de Causa Raíz (RCA) exhaustivo, documentar la línea de tiempo del ataque, identificar fallas en los controles de seguridad y ejecutar un plan formal de acciones correctivas.
Por qué es importante: Los ataques de ransomware exponen debilidades sistémicas subyacentes en la arquitectura de red, los controles de acceso y la visibilidad que volverán a ser explotadas si no se abordan.
Quién debe hacerlo: CISO, Director de Seguridad de OT, Socios Forenses Externos, Liderazgo de la Planta.
Qué NO hacer: No limite las revisiones posteriores al incidente a la remediación técnica de TI, ignorando las brechas en los procedimientos operativos o las fallas en la gestión de proveedores.
Consideraciones de OT: Actualice los manuales de estrategia de respuesta ante incidentes específicos de OT y vuelva a ajustar los motores de detección pasiva de anomalías en función de las tácticas, técnicas y procedimientos (TTP) observados del adversario.
Evidencia/registros a preservar: Informe final post-mortem del incidente, artefactos de la línea de tiempo, matriz de seguimiento de remediación.
Puntos de decisión: ¿Qué modificaciones arquitectónicas (por ejemplo, acceso remoto zero-trust, cumplimiento estricto del Nivel 3.5 de Purdue) se requieren antes de reanudar las operaciones normales?
Errores comunes: Tratar el incidente como cerrado inmediatamente después de la restauración del proceso sin completar el RCA formal y las actualizaciones de resiliencia.
Ransomware en OT: Los primeros 60 minutos
La primera hora de un presunto incidente de ransomware en OT determina si el evento se contiene de manera segura o si escala hacia una interrupción catastrófica de la planta.
Ventana de tiempo | Acción prioritaria | Responsable principal | Objetivo operativo |
0–10 min | Verificar la autenticidad del reporte; confirmar el estado operativo de HMI/alarmas; declarar incidente de OT de Nivel 1. | Supervisor de Turno / SOC de OT | Establecer el estado inicial de seguridad del proceso y evitar acciones de pánico. |
10–20 min | Aislar los enlaces fronterizos de la DMZ de TI/OT (firewalls, acceso remoto por VPN); preservar los canales de comunicación internos locales de OT. | Equipo de Redes / Seguridad de OT | Frenar el movimiento lateral desde la TI corporativa hacia la OT sin interrumpir los lazos de campo locales. |
20–30 min | Evaluar los sistemas de seguridad física (SIS), verificar la preparación para el control manual de procesos, confirmar la visibilidad de HMI de los operadores. | Operador Líder de la Sala de Control | Garantizar la seguridad física de las operaciones de la planta y evitar derivaciones de procesos no monitoreadas. |
30–45 min | Revocar credenciales de dominio comprometidas; finalizar sesiones de salto de RDP/SSH de proveedores activas. | Equipo de Identidad / SysAdmin | Bloquear las vías de acceso remoto en curso de los adversarios hacia las redes de Nivel 3. |
45–60 min | Realizar preservación de datos volátiles en hosts de salto e historiadores clave; iniciar la recopilación estructurada de registros. | Líder de DFIR de OT | Preservar la evidencia perecedera necesaria para el análisis de causa raíz antes de los reinicios del sistema. |
Lista de verificación maestra de respuesta ante incidentes de ransomware en OT
Detección y triaje
[ ] Confirmar la presencia de ransomware mediante indicadores técnicos (nota de rescate, extensiones cifradas, captura de binario).
[ ] Determinar los sistemas afectados a través de los Niveles 0–4 de Purdue.
[ ] Verificar la funcionalidad de los Sistemas Instrumentados de Seguridad (SIS).
[ ] Evaluar el impacto en el proceso físico y la pérdida de visibilidad de los operadores.
[ ] Establecer el nivel inicial de gravedad del incidente y activar el Comando de Incidentes.
Contención
[ ] Cortar la conectividad de límite TI/OT en el firewall de la DMZ de OT.
[ ] Desconectar todo acceso remoto de proveedores externos (VPN, pasarelas celulares).
[ ] Deshabilitar las cuentas de servicio y de usuario de Active Directory comprometidas.
[ ] Aislar los sistemas comprometidos de Nivel 3 únicamente si es operativamente seguro hacerlo.
[ ] Preservar la evidencia de red y de endpoints volátiles antes de los apagados.
Investigación
[ ] Identificar el vector de acceso inicial (por ejemplo, phishing, RDP expuesto, proveedor de la cadena de suministro).
[ ] Mapear las rutas de movimiento lateral y las credenciales de dominio comprometidas.
[ ] Realizar análisis forense en estaciones de trabajo de ingeniería, hosts de salto e historiadores.
[ ] Verificar la lógica de programación de PLC/DCS, las sumas de comprobación de lógica de escalera y los archivos de configuración contra líneas base limpias.
[ ] Buscar puertas traseras secundarias o mecanismos de acceso persistente.
Recuperación
[ ] Validar los respaldos fuera de línea para asegurar su integridad y la ausencia de infección por malware.
[ ] Reconstruir los endpoints afectados utilizando imágenes limpias en una red de pruebas aislada.
[ ] Restaurar la configuración del proceso y las bases de datos de aplicaciones.
[ ] Realizar comprobaciones de integridad operativa con los operadores de la sala de control antes de la conexión en vivo.
[ ] Ejecutar una reconexión controlada y por fases de los segmentos de red de OT mientras se monitorea continuamente la telemetría.
Post-incidente
[ ] Realizar un Análisis de Causa Raíz (RCA) exhaustivo.
[ ] Documentar la línea de tiempo completa del ataque y el informe técnico.
[ ] Implementar medidas de endurecimiento de la segmentación de red y del control de acceso.
[ ] Actualizar los manuales de estrategia de respuesta ante incidentes de OT y capacitar al personal sobre las lecciones aprendidas.
Puntos de vista: CISO frente al operador de OT
Una respuesta exitosa ante incidentes de OT requiere cerrar la brecha de perspectiva fundamental entre el liderazgo de seguridad empresarial y los operadores de la sala de control de la planta.
Área de enfoque estratégico | Visión del CISO / Liderazgo de Seguridad | Visión del Operador de OT / Sala de Control | Síntesis Operativa Integrada |
Objetivo principal | Erradicar la amenaza, evitar la filtración de datos, garantizar el cumplimiento normativo. | Mantener la seguridad física, la estabilidad del proceso y el tiempo de actividad continuo de la producción. | Contener la amenaza de forma segura sin comprometer la integridad del proceso físico ni la seguridad del personal. |
Acción de contención | Aislar las redes y los endpoints afectados de inmediato para detener la propagación del malware. | Mantener los sistemas en funcionamiento; detener el tráfico de red corre el riesgo de interrumpir los lazos de control de la HMI. | Ejecutar un aislamiento de límites quirúrgico y planificado, preservando al mismo tiempo la integridad de los lazos de control locales. |
Comando de incidentes | Regido por los marcos de riesgo de la empresa, el departamento legal y los mandatos regulatorios. | Regido por los procedimientos operativos de emergencia de la planta (EOP) y los protocolos de seguridad física. | Estructura de Comando de Incidentes conjunta con doble autorización requerida para acciones disruptivas. |
Evidencia y análisis forense | Preservar la memoria volátil, las imágenes de disco y los PCAP de red para el análisis de causa raíz. | Priorizar reinicios rápidos del sistema o anulaciones manuales para restaurar la visibilidad de la pantalla de la HMI. | Realizar un triaje rápido y captura de memoria volátil antes de ejecutar los reinicios esenciales. |
Gobernanza de recuperación | Reconstruir todos los sistemas desde cero; imponer restablecimientos completos de contraseñas y ciclos de parches. | Minimizar el tiempo de inactividad; verificar la compatibilidad del software heredado antes de aplicar parches. | Recuperación por fases con rigurosas comprobaciones de seguridad integradas en los procedimientos estándar de reinicio de la planta. |
El límite entre TI y OT: Ruta de propagación del ataque
Comprender cómo el ransomware atraviesa el límite de TI a OT permite a los equipos de respuesta establecer puntos de control estratégicos durante un incidente.
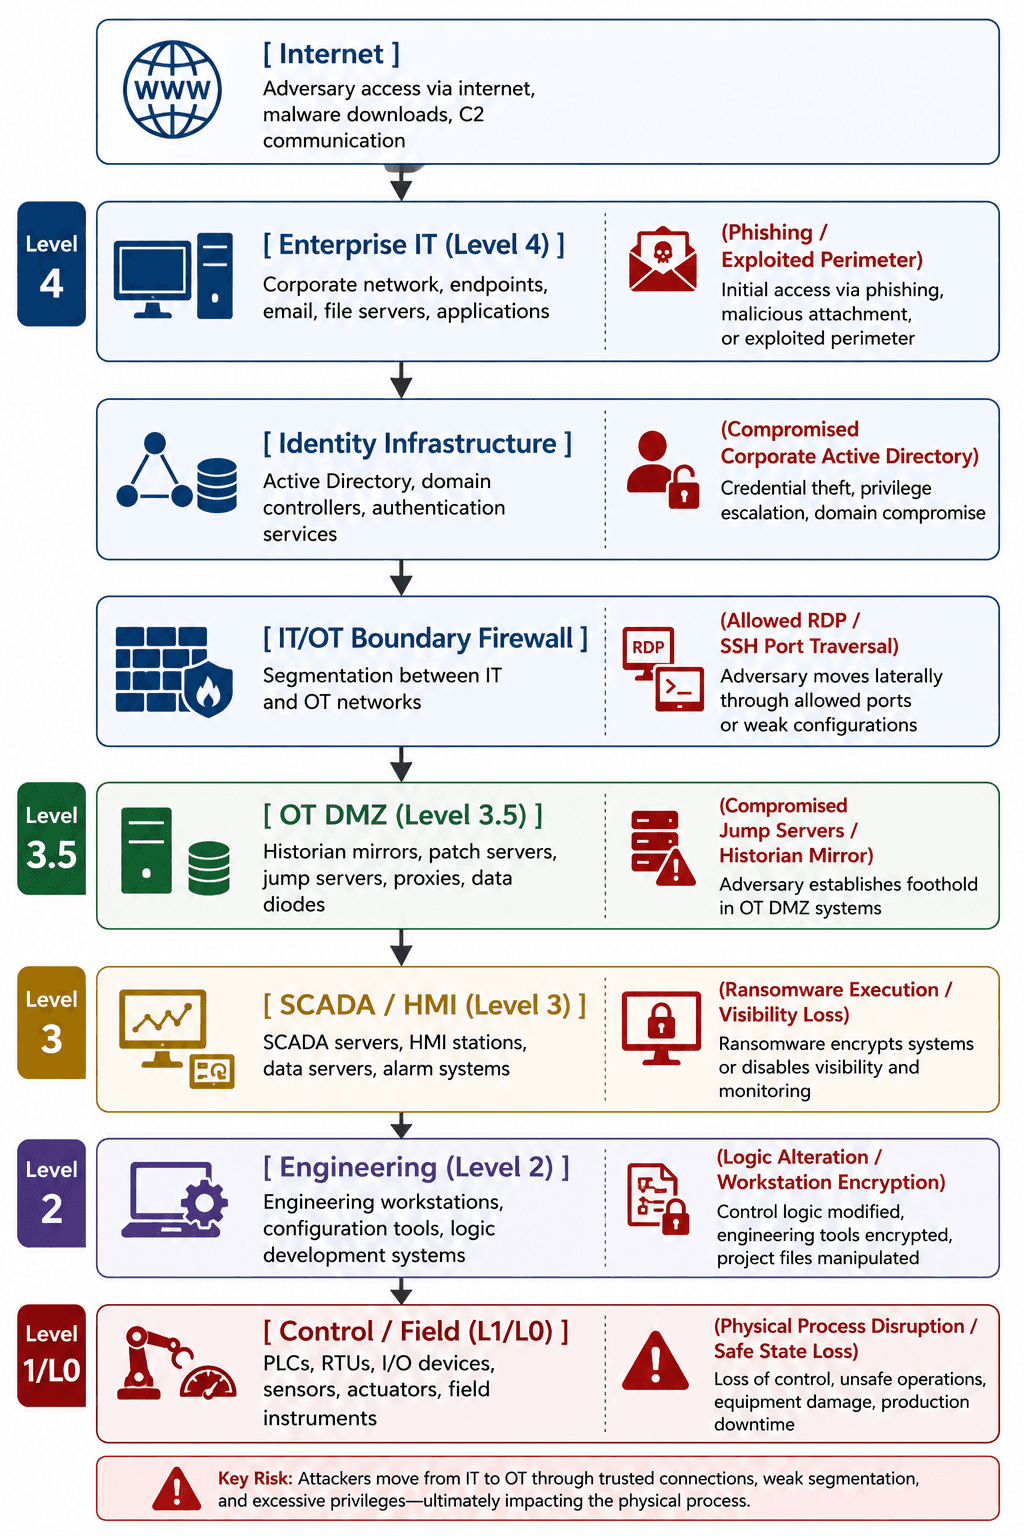
Defensa perimetral y consideraciones de investigación
TI empresarial (Nivel 4): El compromiso inicial ocurre a través de phishing por correo electrónico, archivos adjuntos maliciosos o dispositivos de borde sin parchear. Enfoque de investigación: Registros de correo electrónico, registros de VPN/firewall de borde, alertas de EDR corporativas.
Infraestructura de identidad: Los atacantes recopilan credenciales administrativas y aprovechan las relaciones de confianza entre los dominios de Active Directory empresariales y de OT. Enfoque de investigación: Solicitudes de tickets Kerberos, registros de eventos del controlador de dominio (4624, 4672).
Firewall del límite TI/OT: Los atacantes explotan servidores con doble tarjeta de red o reglas de RDP/SSH abiertas que atraviesan el límite. Enfoque de investigación: Tablas de estado de firewalls, registros de tráfico bloqueado/permitido entre L4 y L3.5.
DMZ de OT (Nivel 3.5): Los atacantes comprometen jump boxes, servidores de administración de parches o espejos de historiadores para pivotar hacia las redes de control. Enfoque de investigación: Registros de sesión RDP de hosts de salto, registros de ejecución de PowerShell, eventos de creación de procesos.
Infraestructura SCADA / HMI (Nivel 3/2): Las cargas útiles de ransomware se ejecutan en HMI y estaciones de ingeniería basadas en Windows/Linux, cifrando archivos de bases de datos y directorios de proyectos. Enfoque de investigación: Modificaciones del sistema de archivos del endpoint, registros de ejecución de aplicaciones, caídas de procesos del servidor SCADA.
Errores en la respuesta al ransomware de OT que pueden empeorar el incidente
Tratar la OT como la TI empresarial: Ejecutar scripts de aislamiento de endpoints automatizados en entornos de OT, lo que puede provocar la caída de HMI críticas o romper los lazos de control.
Desconectar redes sin verificar las dependencias de los procesos: Cortar enlaces de red sin darse cuenta de que los PLC de campo requieren señales de temporización de red específicas o enclavamientos para operar de manera segura.
Reiniciar los sistemas afectados antes de preservar la evidencia: Apagar y encender HMI o controladores de dominio cifrados, destruyendo la memoria volátil (RAM) donde residen las claves de cifrado y los artefactos de malware activos.
Restaurar a partir de respaldos no validados: Restaurar imágenes de sistema sin validar si el respaldo contiene mecanismos de persistencia inactivos del adversario o lógica de configuración corrupta.
Asumir que el ransomware es la única actividad maliciosa: Enfocarse exclusivamente en el cifrado de archivos por ransomware mientras se pasan por alto acciones subyacentes del adversario, como la alteración de la lógica SCADA o la manipulación del sistema de seguridad.
No investigar las credenciales comprometidas: Limpiar los binarios de los endpoints mientras se dejan activas las contraseñas de dominio comprometidas, las claves SSH o los tokens de acceso remoto de proveedores.
Ignorar las estaciones de trabajo de ingeniería (EWS): Enfocar la contención únicamente en las HMI sin inspeccionar los nodos de EWS, donde residen los archivos de proyectos de PLC patentados y el software de control.
Reconectar las redes operativas prematuramente: Volver a conectar segmentos de OT restaurados a las redes corporativas antes de que el entorno empresarial haya sido remediado y saneado a fondo.
Marco de toma de decisiones para la respuesta a ransomware en OT
Utilice este marco de decisión estructurado para guiar elecciones de alta presión durante un incidente activo de ransomware industrial:
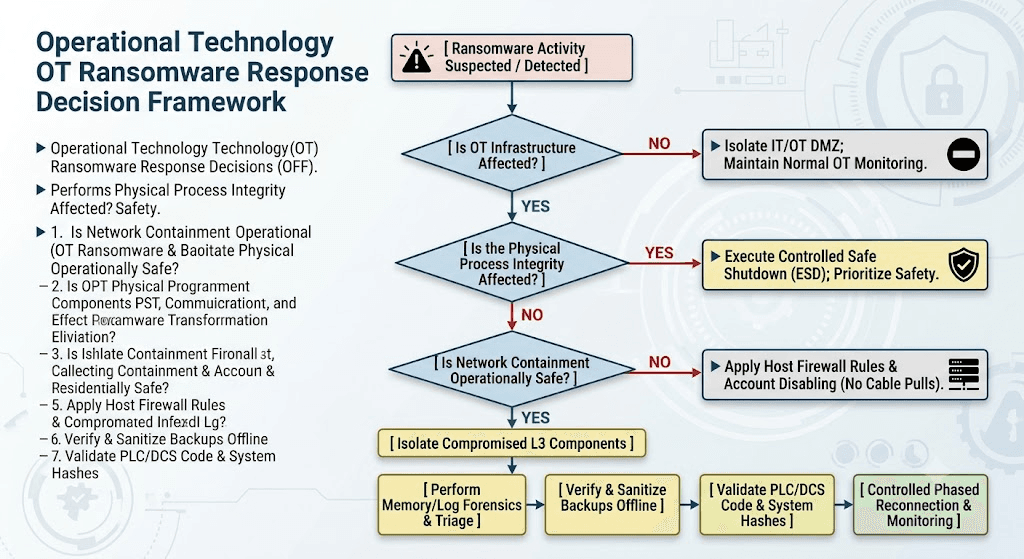
Cuando el ransomware golpea una red operativa, detener el malware es secundario a preservar la seguridad física y el control del proceso.
Al ejecutar estos siete pasos estructurados —declarar el incidente, proteger la seguridad, contener las amenazas de forma quirúrgica, realizar un triaje exhaustivo, erradicar la persistencia por completo, recuperar de forma segura a partir de líneas base limpias y fortalecer la resiliencia del sistema— las organizaciones pueden navegar con éxito ciberincidentes complejos en OT.
En la respuesta al ransomware de OT, el éxito se define no solo por la rapidez con la que se restauran los endpoints, sino por mantener a las personas a salvo, conservar el control de los procesos físicos, preservar la evidencia crítica y volver a poner en línea las operaciones industriales de manera confiable.
Fuentes y referencias autorizadas
Este marco de respuesta se alinea con la guía oficial del gobierno y de los estándares internacionales para la ciberseguridad de sistemas de control industrial:
NIST SP 800-82 Rev. 3: Guide to Operational Technology (OT) Security: Establece los principios fundamentales de seguridad, disponibilidad y segmentación para redes industriales.
NIST SP 800-61 Rev. 3: Incident Response Recommendations and Considerations: Formula ciclos de vida de manejo de incidentes de manera adaptable a través de los dominios organizacionales.
NIST Cybersecurity Framework (CSF) 2.0 y Perfil de gestión de riesgos de ransomware (NIST IR 8374): Describe la postura de seguridad fundamental y las pautas de recuperación específicas para las amenazas de ransomware.
Guía de manejo de incidentes de ICS de CISA: Proporciona directivas de procedimiento para el manejo de incidentes operativos en sectores de infraestructura crítica.
Serie ISA/IEC 62443: Define los estándares técnicos para los niveles de seguridad, la segmentación de zonas/conductos y la evaluación de riesgos en la automatización industrial.
Recibe semanalmente
Recursos y Noticias
Vea cómo nuestras soluciones de seguridad de OT líderes en la industria abordan los desafíos de seguridad críticos
También te puede interesar

What the French supermarket cyberattack reveals about OT security
Prayukth K V

Inside the Albert Heijn cyber incident: Investigating the attack, the IT/OT exposure, and the risks to critical operations
Team Shieldworkz

50°C by cyberattack? Inside France’s supermarket refrigeration crisis
Prayukth K V

Automating IEC 62443 Compliance Assessments Without Losing Expert Control
Team Shieldworkz

Investigative cyber threat intelligence report: Daiichi Kosho supply-chain data exposure
Prayukth K V

How AI Is Changing IEC 62443 Assessments
Team Shieldworkz







