

Die Top 7 Incident-Response-Schritte bei einem Ransomware-Angriff auf OT-Betriebsnetzwerke


Team Shieldworkz
Ransomware-Angriffe auf Operational Technology (OT) und Industrial Control Systems (ICS) stellen einen unmittelbaren betrieblichen Notfall dar. Im Gegensatz zu einem Vorfall in der Unternehmens-IT, bei dem verschlüsselte Server lediglich Datenverlust und Betriebsunterbrechungen bedeuten, bedroht OT-Ransomware die physische Prozesssteuerung, die Umweltsicherheit, das Leben von Mitarbeitern und die Verfügbarkeit kritischer Infrastrukturen (KRITIS).
Wenn Ransomware in oder nahe industrieller Steuerungsumgebungen auftritt, können Standard-Playbooks der Unternehmens-IT – insbesondere die automatisierte Isolierung von Endgeräten und pauschale Netzwerktrennungen – plötzliche, unsichere Prozessabschaltungen auslösen. Dieser Artikel bietet einen fundierten Incident-Response-Leitfaden, der speziell für CISOs, Leiter der OT-Sicherheit, Leitstandsfahrer und OT-SOC-Teams konzipiert ist.
Der OT-spezifische Incident-Response-Kontext
Die Incident Response in der klassischen IT priorisiert Datenvertraulichkeit, Netzwerkeindämmung und schnelle Behebung an Endgeräten. Industrielle Steuerungssysteme priorisieren dagegen Personensicherheit, Prozesssicherheit, betriebliche Verfügbarkeit und Prozessintegrität.
Indiskriminierte Eindämmungsmaßnahmen in der OT bergen erhebliche betriebliche Risiken. Ungeplante Abschaltungen können zu Überdruck, thermischem Durchgehen, Freisetzung gefährlicher Chemikalien, schweren Schäden an Anlagen oder Instabilitäten im regionalen Stromnetz führen.
Warum sich die Reaktion auf OT-Ransomware von der IT-Sicherheit unterscheidet
Sicherheit und Stabilität an erster Stelle: Das Hauptziel der Reaktion in der OT ist es, die Cyber-Bedrohung einzudämmen und gleichzeitig einen sicheren Betriebszustand aufrechtzuerhalten. Das Stoppen von Schadsoftware darf nicht auf Kosten der Prozesssicherheit gehen.
Prozessabhängigkeiten & Verlust der Sichtbarkeit: Das blinde Trennen von Netzwerkverbindungen zu Human-Machine Interfaces (HMIs), Engineering Workstations oder SCADA-Servern entzieht dem Leitstandspersonal jegliche Sichtbarkeit und manuelle Eingriffsmöglichkeiten.
Legacy-Infrastruktur & Legacy-Protokolle: OT-Umgebungen nutzen häufig veraltete Betriebssysteme ohne Support sowie unverschlüsselte Industrieprotokolle ohne Authentifizierung (z. B. Modbus TCP, DNP3, EtherNet/IP). Diesen Protokollen fehlen grundlegende integrierte Sicherheitsfunktionen wie Verschlüsselung oder Payload-Validierung.
IT-to-OT Lateral Movement: Ransomware entsteht selten auf Feldgeräten der Ebene 1 (PLC/RTU). Meist dringt sie über die Unternehmens-IT (Ebene 4) ein, durchquert die OT-DMZ (Ebene 3.5) und zielt auf SCADA-Komponenten, Engineering-Software und Historian-Server (Ebene 3/2) ab.
Eine moderne Reaktion auf OT-Vorfälle muss mit NIST SP 800-82 Rev. 3 (Guide to Operational Technology Security), NIST SP 800-61 Rev. 3 (Incident Response Recommendations and Considerations), den CISA ICS Incident Handling Guidelines und der Normenreihe ISA/IEC 62443 harmonieren. Das blinde Trennen von Systemen widerspricht den Grundsätzen des BSI und der CISA, wonach die Eindämmung niemals sicherheitsgerichtete Funktionen (Safety Instrumented Functions, SIF) oder kritische Regelungskreise beeinträchtigen darf.
Die 7 wichtigsten Schritte der Incident Response
Schritt 1: Vorfall deklarieren und klassifizieren
Bestimmen Sie schnell das Schadensausmaß und stellen Sie fest, ob es sich um ein reines IT-Ereignis, ein OT-nahes Risiko oder eine aktive Beeinträchtigung des physischen Prozesses handelt.
Was zu tun ist: Deklarieren Sie formell einen OT-Sicherheitsvorfall, richten Sie eine gemeinsame Krisenstabsstruktur aus IT-Sicherheit und Anlagenbetrieb ein und weisen Sie eine betriebliche Priorisierungsstufe zu.
Warum es wichtig ist: Es verhindert, dass IT-Sicherheitsteams einseitige Eindämmungsmaßnahmen ergreifen, die den Anlagenbetrieb stören, ohne dass das Leitstandspersonal informiert ist.
Wer es tun sollte: Incident Commander, CISO, Leiter OT-Sicherheit, leitender Betriebsleiter.
Was NICHT zu tun ist: Versuchen Sie nicht, aktive Ransomware-Infektionen auf der Ebene-3-Infrastruktur im Stillen zu beheben, ohne den Vorfall offiziell zu deklarieren und die Leitstandsbediener zu benachrichtigen.
OT-Spezifika: Prüfen Sie, ob die Ransomware Systemdateien des zugrunde liegenden Betriebssystems verschlüsselt oder lediglich den Zugriff auf die ausführbaren Dateien des SCADA-HMI blockiert.
Aufzubewahrende Nachweise/Logs: Firewall-Protokolle (IT/OT-DMZ), Active-Directory-Protokolle, erste Benutzermeldungen, Aufzeichnungen von Endpoint-Detection-Alarmen, Speicherabzüge (Memory Dumps) betroffener Jump-Hosts.
Entscheidungspunkte: Ist die Ransomware auf IT-Systeme der Ebene 4 oder die DMZ (Ebene 3.5) beschränkt, oder hat sie bereits Steuerungsnetzwerke der Ebenen 3/2 erreicht?
Häufige Fehler: Klassifizierung eines Vorfalls als reines „IT-Problem“, obwohl das Active Directory des Unternehmens (das auch OT-Jump-Hosts verwaltet) kompromittiert ist.
Checkliste für die Erst-Triage:
[ ] Bestätigen Sie die gemeldeten Symptome (z. B. Dateiendungen mit .locked, Erpresserschreiben, Abstürze von HMI-Anwendungen).
[ ] Stellen Sie sicher, dass sicherheitsgerichtete Systeme (SIS) oder Sicherheitssteuerungen online und unbeeinträchtigt sind.
[ ] Überprüfen Sie die Sichtbarkeit der primären physischen Prozessregelungskreise für die Leitstandsbediener.
[ ] Berufen Sie innerhalb von 15 Minuten nach der vermuteten Erkennung eine gemeinsame IT/OT-Krisenstabs-Sitzung ein.
Schritt 2: Sicherheit gewährleisten und den industriellen Prozess stabilisieren
Bewerten Sie den Zustand der physischen Betriebssicherheit, bevor Sie technische Eindämmungsmaßnahmen oder forensische Befehle ausführen.
Was zu tun ist: Binden Sie die Leitstandsbediener ein, um zu prüfen, ob Echtzeit-Telemetrie, Alarmüberwachung, Fernsteuerungsfunktionen und Sicherheitssysteme weiterhin funktionsfähig und vertrauenswürdig sind.
Warum es wichtig ist: Wenn Bediener die HMI-Sichtbarkeit oder die Prozesskontrolle verlieren, muss die Anlage in einen kontrollierten, manuellen Sicherheitszustand überführt oder eine geordnete Notabschaltung (Emergency Shutdown, ESD) eingeleitet werden.
Wer es tun sollte: Schichtführer, Leitstandsfahrer, Automatisierungsingenieure.
Was NICHT zu tun ist: Führen Sie keine Massen-Reboots durch und fahren Sie keine Engineering-Server herunter, solange Bediener diese zur Überwachung kritischer Prozessparameter benötigen.
OT-Spezifika: Cyber-Incident-Response-Teams müssen sich bezüglich der physischen Sicherheit und der Abschaltverfahren mit den zertifizierten Anlagenbedienern abstimmen.
Aufzubewahrende Nachweise/Logs: Alarmhistorie-Protokolle, Bediener-Aktionsprotokolle, Historian-Trenddaten, Ereignisaufzeichnungen der Prozesssicherheit.
Entscheidungspunkte: Können die Bediener den sicheren Zustand manuell aufrechterhalten, wenn die SCADA-Software der Ebene 3 ausfällt? Wenn nein, leiten Sie eine kontrollierte Prozessabschaltung ein.
Häufige Fehler: Den Ausfall von HMI-Bildschirmaktualisierungen als einfachen Softwarefehler abzutun, anstatt als cyber-bedingten Verlust der Prozesssichtbarkeit.
Checkliste zur Prozesssicherheit:
[ ] Überprüfen Sie die Funktion der sicherheitsgerichteten Systeme (SIS) unabhängig von den Basis-Prozesssteuerungssystemen (BPCS).
[ ] Stellen Sie sicher, dass manuelle Übersteuerungsfunktionen für kritische Ventile, Leistungsschalter und Pumpen einsatzbereit sind.
[ ] Stellen Sie sicher, dass sekundäre Kommunikationskanäle (Funk, Festnetz) zwischen Leitstand und Feldtechnikern aktiv sind.
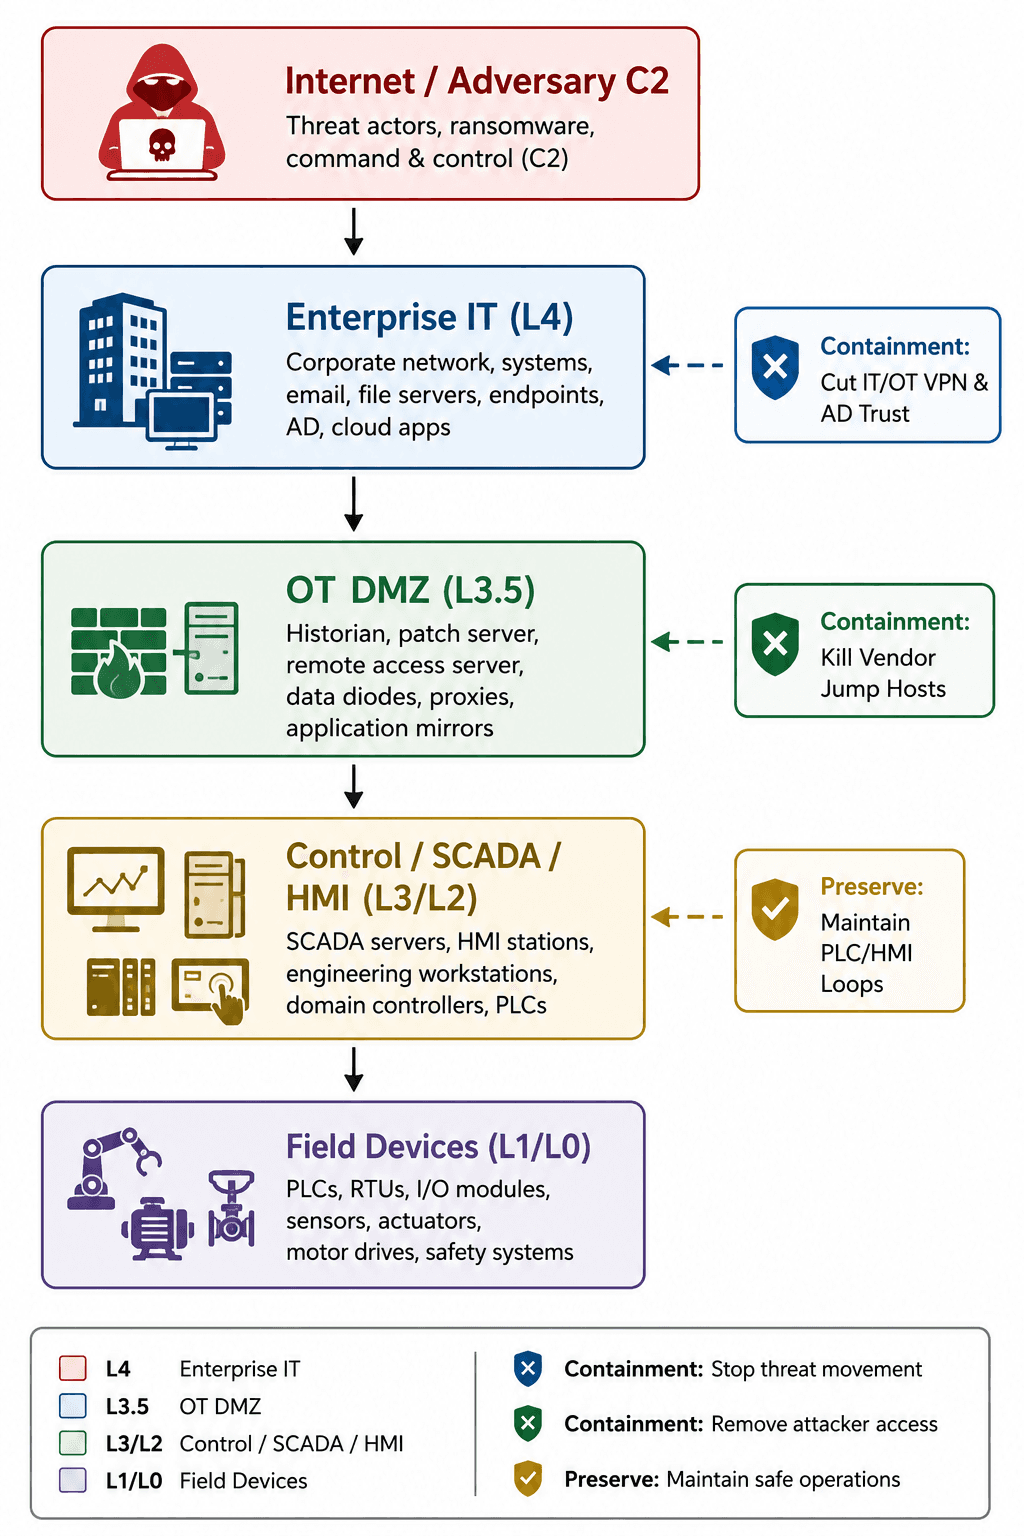
Schritt 3: Den Angriff eindämmen, ohne die OT blind zu stören
Wenden Sie gezielte Netzwerk- und Identitäts-Eindämmungsmaßnahmen an, um die Ausbreitung der Ransomware zu verhindern, ohne die kritische Steuerungskommunikation zu unterbrechen.
Was zu tun ist: Trennen Sie nicht zwingend erforderliche IT/OT-Grenzverbindungen, beenden Sie den Fernzugriff von Drittanbietern (VPNs, Jump-Boxes), schränken Sie kompromittierte Dienstkonten ein und blockieren Sie bösartige C2-IP-Adressen an der Firewall der OT-DMZ.
Warum es wichtig ist: Die Eindämmung verhindert ein Lateral Movement aus den IT-Netzwerken der Unternehmensleitung in die operativen Netzwerke der Ebene 3, während die interne OT-Kommunikation (PLCs zu HMIs) weiterlaufen kann.
Wer es tun sollte: OT-Netzwerkingenieure, Spezialisten für Firewalls/Netzwerksicherheit, OT-SOC-Analysten.
Was NICHT zu tun ist: Schalten Sie keine Ports an zentralen OT-Switches pauschal ab und deaktivieren Sie keine internen OT-Domain-Controller, ohne die Auswirkungen auf den Prozess zu prüfen.
OT-Spezifika: Das Trennen eines OT-Domain-Controllers kann dazu führen, dass die Authentifizierung veralteter HMIs fehlschlägt, wodurch der Zugriff auf die Steuerungsschnittstellen sofort verloren geht.
Aufzubewahrende Nachweise/Logs: Firewall-Änderungsprotokolle, aktive VPN-Sitzungsprotokolle, PCAP-Dateien isolierter Endgeräte, Berechtigungsänderungen im Active Directory.
Entscheidungspunkte: Wann muss die IT von der OT isoliert werden? Isolieren Sie sofort an der Firewall der OT-DMZ, wenn das Active Directory des Unternehmens kompromittiert ist oder sich Ransomware auf Ebene 4 aktiv ausbreitet.
Häufige Fehler: Das Trennen von Netzwerkverbindungen, die lebenswichtige Prozesssynchronisations- oder Sicherheitsverriegelungsdaten zwischen physischen Einheiten übertragen.
Schritt 4: OT-spezifische Triage und Beweissicherung durchführen
Lokalisieren Sie die Spuren des Angreifers in der OT-Infrastruktur, während Sie flüchtige Beweise sicher aufbewahren.
Was zu tun ist: Erfassen Sie flüchtigen Speicher, analysieren Sie forensische Artefakte (MFT, Ereignisprotokolle, Shimcache), überprüfen Sie Engineering-Projektdateien und kontrollieren Sie die Konfigurations-Baselines von PLC/DCS-Logiken.
Warum es wichtig ist: Angreifer setzen Ransomware oft als destruktive Ablenkung ein, um sekundäre Ziele zu verschleiern – etwa die Modifikation von Sicherheitsparametern, die Änderung von PLC-Logiken oder den Diebstahl geschützter Prozessdokumentationen.
Wer es tun sollte: Leitende Spezialisten für OT-Digital Forensics & Incident Response (DFIR), Automatisierungsingenieure.
Was NICHT zu tun ist: Führen Sie keine invasiven, volumenintensiven Schwachstellenscans (z. B. aktive Nmap-Sweeps) in Altsystemen der OT-Netzwerke durch, da dies zum Absturz von Legacy-PLCs führen kann.
OT-Spezifika: Priorisieren Sie die Datenerfassung von Jump-Servern, Engineering Workstations (EWS) und Historians, da diese Angreifern als zentrale Stützpunkte dienen.
Aufzubewahrende Nachweise/Logs: RAM-Abzüge, Systemereignisprotokolle (System.evtx, Security.evtx), Netflow-Aufzeichnungen, PLC-Projektdateien (.ACD, .ap13 etc.), Historian-Datenbanken.
Entscheidungspunkte: Hat der Angreifer die Programmlogik von PLC/DCS modifiziert oder ist die Bedrohung auf die zugrunde liegenden Windows/Linux-Betriebssystemumgebungen beschränkt?
Häufige Fehler: Das Neuaufspielen eines infizierten HMI-Images, bevor RAM- oder Festplatten-Artefakte gesichert wurden, wodurch wichtige Beweise zur Ursachenanalyse vernichtet werden.
OT-Triage-Checkliste
[ ] Überprüfen Sie Active-Directory-Konten auf neu angelegte, unautorisierte administrative Benutzer.
[ ] Vergleichen Sie die Prüfsummen von Engineering-Projektdateien mit bekannten Offline-Baselines.
[ ] Sichern Sie den Arbeitsspeicher und Protokolle von betroffenen Jump-Hosts und Historians.
[ ] Prüfen Sie externe Fernzugriffsprotokolle (RDP, TeamViewer, AnyDesk, SSH) auf anomale Zugriffe.
Schritt 5: Bereinigung der Bedrohung und Validierung der Umgebung
Eliminieren Sie die Persistenz des Angreifers, bösartige Werkzeuge und kompromittierte Zugangsdaten sowohl in der Unternehmens- als auch in der OT-Domäne.
Was zu tun ist: Löschen Sie unbefugte Benutzerkonten, setzen Sie alle Kennwörter in den Unternehmens- und OT-Domänen zurück, entziehen Sie kompromittierte API-Schlüssel, erstellen Sie betroffene Endgeräte aus verifizierten Images neu und schließen Sie ausgenutzte Schwachstellen durch Patches.
Warum es wichtig ist: Ransomware-Dateien sind nur die Payload. Wenn aktive Backdoors, geplante Aufgaben oder kompromittierte SSH-Schlüssel im System verbleiben, können Angreifer die Systeme Tage nach der Wiederherstellung erneut verschlüsseln.
Wer es tun sollte: OT-Sicherheitsingenieure, Systemadministratoren, DFIR-Spezialisten.
Was NICHT zu tun ist: Gehen Sie nicht davon aus, dass die Bereinigung mit dem Löschen der ausführbaren Ransomware-Datei (.exe) abgeschlossen ist.
OT-Spezifika: Kennwortänderungen müssen sorgfältig koordiniert werden. Das Ändern von Passwörtern für Dienstkonten, die an fest codierte SCADA/DCS-Datenbankverbindungen gebunden sind, kann zum Absturz von Anwendungsdiensten führen.
Aufzubewahrende Nachweise/Logs: Ergebnisse von Schwachstellenscans nach der Bereinigung, Audits von Konfigurationsänderungen, Validierungshashes der Baseline.
Entscheidungspunkte: Wurden alle Persistenzvektoren sowohl in der IT- als auch in der OT-Umgebung identifiziert und beseitigt, bevor mit der vollständigen Systemwiederherstellung begonnen wird?
Häufige Fehler: Das Versäumnis, lokale Administrator-Passwörter auf nicht in die Domäne eingebundenen Legacy-HMIs zurückzusetzen.
Checkliste zur Validierung der Bereinigung:
[ ] Führen Sie einen 100-prozentigen Passwort-Reset für alle OT-Domänenkonten, Dienstkonten und lokalen Admin-Konten durch.
[ ] Beenden Sie alle Fernzugriffszertifikate und MFA-Token (Multi-Faktor-Authentifizierung) und stellen Sie diese neu aus.
[ ] Entfernen Sie alle Persistenzmechanismen (unautorisierte Dienste, geplante Aufgaben, Registry-Run-Keys).
[ ] Validieren Sie PLC/DCS-Firmware-Signaturen und gleichen Sie den PLC-Code mit sauberen Offline-Referenzkopien ab.
Schritt 6: OT-Systeme sicher wiederherstellen
Bauen Sie OT-Anwendungen, Datenbanken und Steuerungsknoten systematisch unter Verwendung sauberer, verifizierter Backups wieder auf.
Was zu tun ist: Stellen Sie System-Images und Prozessdatenbanken aus verifizierten, physisch getrennten (Air-Gapped) Backups wieder her. Validieren Sie die Programmlogik, führen Sie funktionale Offline-Tests durch und nehmen Sie eine kontrollierte, schrittweise Wiederverbindung vor.
Warum es wichtig ist: Das Einspielen eines nicht validierten Backups kann dazu führen, dass schlafende Schadsoftware oder korrupte Prozesskonfigurationen erneut in die aktive Steuerungsumgebung eingebracht werden.
Wer es tun sollte: Automatisierungsingenieure, Systemadministratoren, Team für den Anlagenbetrieb.
Was NICHT zu tun ist: Verbinden Sie wiederhergestellte OT-Netzwerke erst dann wieder mit der Unternehmens-IT, wenn die IT-Umgebung vollständig bereinigt und validiert wurde.
OT-Spezifika: Stellen Sie sicher, dass wiederhergestellte Historian-Datenbanken und SCADA-Projektdateien den Betriebsparametern vor dem Vorfall entsprechen, bevor die Systeme die Steuerung wieder übernehmen.
Aufzubewahrende Nachweise/Logs: Protokolle zur Validierung der Wiederherstellung, Checklisten vor der Inbetriebnahme, Dokumentation der betrieblichen Freigabe.
Entscheidungspunkte: Ist das Offline-Backup sauber, unbeschädigt und nachweislich sicher für den Produktivbetrieb?
Häufige Fehler: Das Starten wiederhergestellter virtueller Maschinen mit Verbindung zum produktiven Netzwerk, ohne diese zuvor zur Sicherheitsüberprüfung isoliert zu haben.
Schritt 7: Post-Incident-Analyse durchführen und Resilienz stärken
Analysieren Sie die Ursache des Vorfalls, identifizieren Sie strukturelle Lücken und härten Sie die OT-Abwehr gegen zukünftige zerstörerische Angriffe.
Was zu tun ist: Führen Sie eine umfassende Root Cause Analysis (RCA) durch, dokumentieren Sie den zeitlichen Ablauf des Angriffs, identifizieren Sie Schwachstellen in den Sicherheitskontrollen und setzen Sie einen formalen Korrekturmaßnahmenplan um.
Warum es wichtig ist: Ransomware-Angriffe decken tief liegende systematische Schwächen in der Netzwerkarchitektur, den Zugriffskontrollen und der Sichtbarkeit auf, die bei Nichtbeachtung erneut ausgenutzt werden.
Wer es tun sollte: CISO, Leiter OT-Sicherheit, externe Forensik-Partner, Werksleitung.
Was NICHT zu tun ist: Beschränken Sie die Nachbereitung des Vorfalls nicht auf technische IT-Maßnahmen, während Sie prozedurale Lücken im Betrieb oder Mängel im Dienstleistermanagement ignorieren.
OT-Spezifika: Aktualisieren Sie OT-spezifische Incident-Response-Playbooks und passen Sie passive Anomalieerkennungssysteme basierend auf den beobachteten Taktiken, Techniken und Prozeduren (TTPs) des Angreifers an.
Aufzubewahrende Nachweise/Logs: Abschlussbericht zum Vorfall (Post-Mortem), Zeitleisten-Artefakte, Nachverfolgungsmatrix für Behebungsmaßnahmen.
Entscheidungspunkte: Welche architektonischen Anpassungen (z. B. Zero-Trust-Fernzugriff, strikte Durchsetzung von Purdue-Ebene 3.5) sind vor der Wiederaufnahme des Normalbetriebs zwingend erforderlich?
Häufige Fehler: Den Vorfall direkt nach der Wiederherstellung der Prozesse als abgeschlossen zu betrachten, ohne die formale RCA und die Resilienz-Updates abgeschlossen zu haben.
OT-Ransomware: Die ersten 60 Minuten
Die erste Stunde eines vermuteten OT-Ransomware-Vorfalls entscheidet darüber, ob das Ereignis sicher eingegrenzt werden kann oder in einen katastrophalen Betriebsausfall mündet.
Zeitfenster | Priorisierte Maßnahme | Hauptverantwortlicher | Betriebliches Ziel |
0–10 Min. | Echtheit der Meldung prüfen; HMI/Alarm-Betriebsstatus bestätigen; OT-Vorfall der Prioritätsstufe 1 deklarieren. | Schichtführer / OT SOC | Erfassung des aktuellen Prozesssicherheitsstatus und Verhinderung von Panikreaktionen. |
10–20 Min. | Grenzverbindungen der IT/OT-DMZ isolieren (Firewalls, VPN-Zugänge); lokale interne OT-Kommunikationskanäle aufrechterhalten. | OT-Netzwerk- / Sicherheitsteam | Unterbindung des Lateral Movement von der Unternehmens-IT zur OT ohne Störung lokaler Feldregelungskreise. |
20–30 Min. | Physische Sicherheitssysteme (SIS) bewerten, Bereitschaft zur manuellen Prozesssteuerung prüfen, HMI-Sichtbarkeit verifizieren. | Leitstandsfahrer | Gewährleistung der physischen Sicherheit des Anlagenbetriebs und Vermeidung unüberwachter Prozessabweichungen. |
30–45 Min. | Kompromittierte Domänen-Zugangsdaten sperren; aktive RDP-/SSH-Sitzungen von Drittanbietern beenden. | Identity- / SysAdmin-Team | Blockieren laufender Fernzugriffspfade von Angreifern in Netzwerke der Ebene 3. |
45–60 Min. | Sicherung flüchtiger Daten auf zentralen Jump-Hosts/Historians durchführen; strukturierte Log-Erfassung einleiten. | OT-DFIR-Leiter | Sicherung flüchtiger Beweise für die Ursachenanalyse vor eventuellen System-Reboots. |
Master-Checkliste für OT-Ransomware-Vorfälle
Erkennung und Triage
[ ] Bestätigen Sie das Vorliegen von Ransomware durch technische Indikatoren (Erpresserschreiben, verschlüsselte Dateiendungen, Analyse der Schadsoftware).
[ ] Identifizieren Sie betroffene Systeme über die Purdue-Ebenen 0–4 hinweg.
[ ] Überprüfen Sie die Funktionsfähigkeit der sicherheitsgerichteten Systeme (SIS).
[ ] Bewerten Sie die Auswirkungen auf physische Prozesse und den Verlust der HMI-Sichtbarkeit.
[ ] Legen Sie die Prioritätsstufe des Vorfalls fest und aktivieren Sie den Krisenstab.
Eindämmung
[ ] Trennen Sie die IT/OT-Verbindungen an der Firewall der OT-DMZ.
[ ] Deaktivieren Sie alle externen Fernzugriffe von Drittanbietern (VPNs, Mobilfunk-Gateways).
[ ] Sperren Sie kompromittierte Active-Directory-Benutzer- und Dienstkonten.
[ ] Isolieren Sie kompromittierte Ebene-3-Systeme nur dann, wenn dies betrieblich sicher möglich ist.
[ ] Sichern Sie Netzwerkdaten und flüchtige Endpunktdaten vor dem Herunterfahren von Systemen.
Untersuchung
[ ] Identifizieren Sie den initialen Angriffsvektor (z. B. Phishing, offene RDP-Ports, Lieferantennetzwerk).
[ ] Rekonstruieren Sie die Pfade des Lateral Movement und kompromittierte Domänen-Zugangsdaten.
[ ] Führen Sie forensische Analysen auf Engineering Workstations, Jump-Hosts und Historians durch.
[ ] Überprüfen Sie die Programmlogik von PLC/DCS, Prüfsummen des Codes sowie Konfigurationsdateien anhand sauberer Baselines.
[ ] Suchen Sie nach sekundären Backdoors oder persistenten Zugriffspfaden.
Wiederherstellung
[ ] Überprüfen Sie Offline-Backups auf Integrität und Schadsoftwarefreiheit.
[ ] Bauen Sie betroffene Endgeräte mit sauberen Images in einem isolierten Testnetzwerk neu auf.
[ ] Stellen Sie die Prozesskonfigurationen und Anwendungsdatenbanken wieder her.
[ ] Führen Sie betriebliche Funktionsprüfungen gemeinsam mit den Leitstandsbedienern vor der Live-Schaltung durch.
[ ] Verbinden Sie OT-Netzwerksegmente kontrolliert und schrittweise wieder, während Sie die Telemetrie kontinuierlich überwachen.
Nachbereitung
[ ] Führen Sie eine umfassende Ursachenanalyse (Root Cause Analysis, RCA) durch.
[ ] Dokumentieren Sie den vollständigen zeitlichen Ablauf des Angriffs in einem technischen Bericht.
[ ] Setzen Sie Maßnahmen zur Netzwerksegmentierung und zur Härtung von Zugriffskontrollen um.
[ ] Aktualisieren Sie die OT-Incident-Response-Playbooks und schulen Sie das Personal basierend auf den gewonnenen Erkenntnissen.
Perspektiven: CISO vs. OT-Bediener
Eine erfolgreiche Reaktion auf OT-Sicherheitsvorfälle erfordert es, die unterschiedlichen Sichtweisen der IT-Sicherheitsleitung und des Betriebspersonals im Leitstand in Einklang zu bringen.
Strategischer Fokusbereich | Sichtweise CISO / Sicherheitsleitung | Sichtweise OT / Leitstandsbediener | Integrierte operative Synthese |
Hauptziel | Bedrohung beseitigen, Datenabfluss verhindern, regulatorische Compliance (z. B. BSIG/KRITIS) sicherstellen. | Physische Sicherheit, Prozessstabilität und kontinuierliche Produktion aufrechterhalten. | Bedrohung sicher eindämmen, ohne die physische Prozessintegrität oder Personensicherheit zu gefährden. |
Eindämmungsmaßnahme | Betroffene Netzwerke und Endgeräte sofort isolieren, um die Ausbreitung von Schadsoftware zu stoppen. | Systeme aktiv lassen; das Stoppen des Netzwerkverkehrs birgt das Risiko des Ausfalls von HMI-Regelungskreisen. | Gezielte, geplante Grenzisoliertungen durchführen, während die lokale Integrität der Regelungskreise gewahrt bleibt. |
Krisenstabssteuerung | Gesteuert durch Risikomanagement-Frameworks, Rechtsabteilung und gesetzliche Meldepflichten. | Gesteuert durch Notfallpläne der Anlage und physische Sicherheits- und Unfallverhütungsvorschriften. | Gemeinsame Krisenstabsstruktur mit doppelter Autorisierungspflicht für betriebsstörende Maßnahmen. |
Beweissicherung & Forensik | Flüchtigen Speicher, Festplatten-Images und Netzwerk-PCAPs für die Ursachenanalyse sichern. | Schnelle System-Reboots oder manuelle Eingriffe priorisieren, um die HMI-Sichtbarkeit wiederherzustellen. | Schnelle Triage und Sicherung des flüchtigen Speichers durchführen, bevor zwingend erforderliche Neustarts erfolgen. |
Wiederherstellungsprozess | Alle Systeme von Grund auf neu aufbauen; vollständige Passwortänderungen und Patch-Zyklen erzwingen. | Ausfallzeiten minimieren; Kompatibilität von Altsystem-Software prüfen, bevor Patches eingespielt werden. | Schrittweise Wiederherstellung mit strengen Sicherheitsprüfungen, integriert in die Standard-Anlaufverfahren der Anlage. |
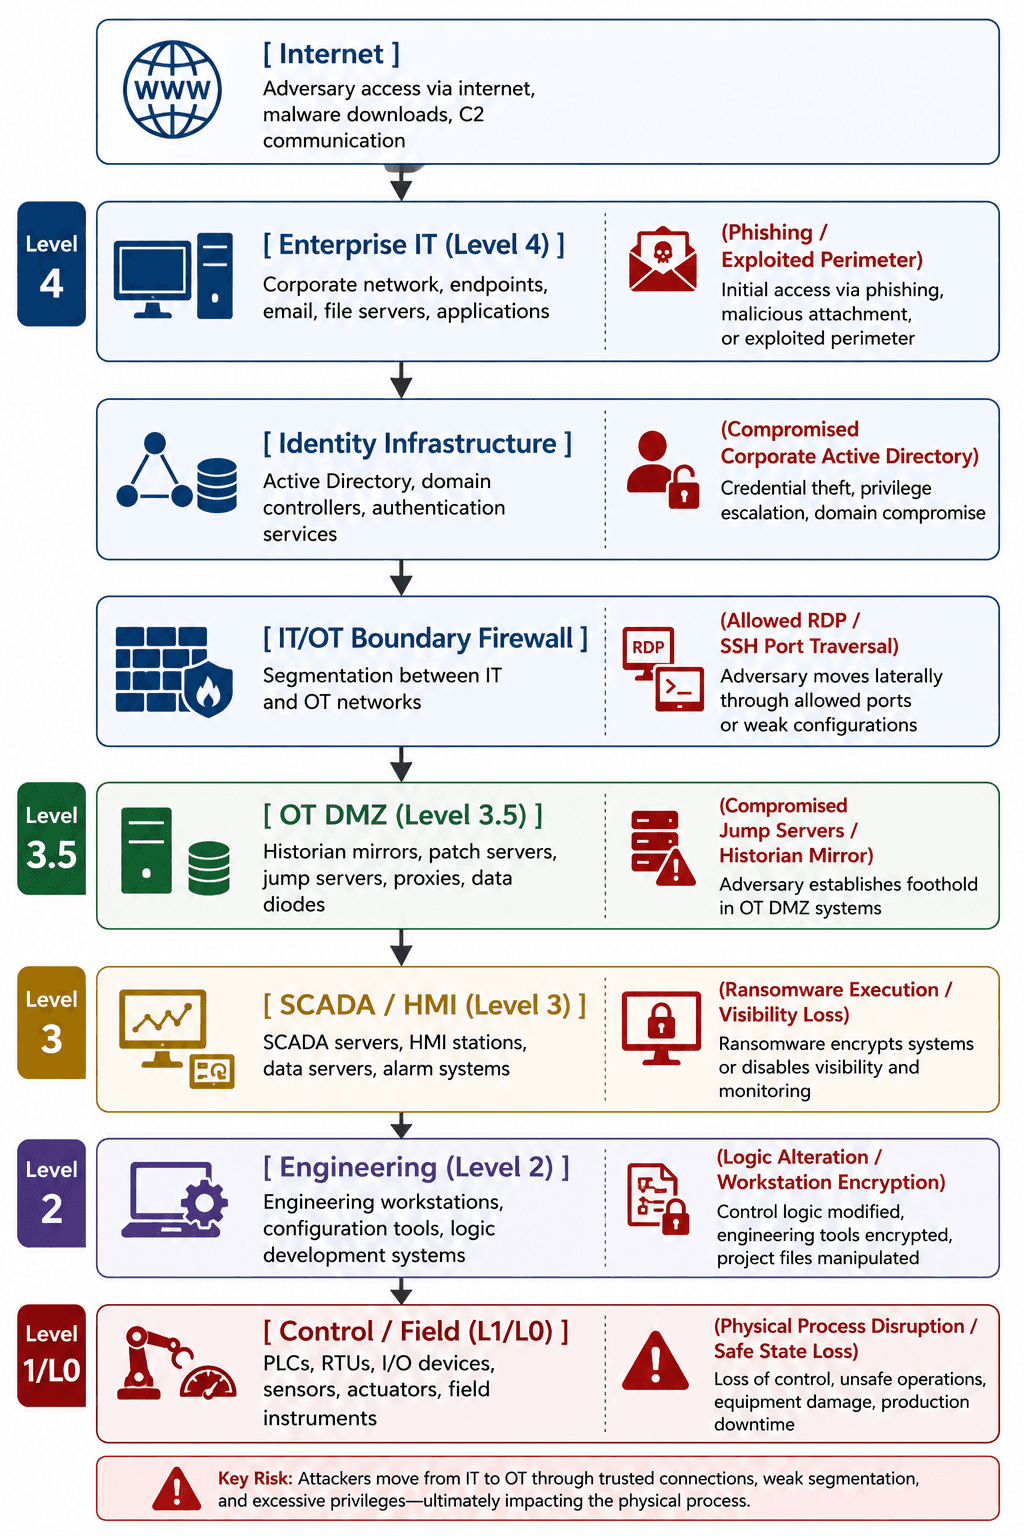
Die IT-OT-Schnittstelle: Ausbreitungspfad des Angriffs
Das Verständnis darüber, wie Ransomware die Grenze zwischen IT und OT überschreitet, ermöglicht es Einsatzkräften, während eines Vorfalls gezielte Kontrollpunkte (Chokepoints) einzurichten.
Perimeterschutz und investigative Aspekte
Unternehmens-IT (Ebene 4): Die Erstkompromittierung erfolgt meist über Phishing-E-Mails, schädliche Anhänge oder ungepatchte Edge-Geräte. Fokus der Untersuchung: E-Mail-Protokolle, Edge-VPN-/Firewall-Protokolle, EDR-Alarme des Unternehmens.
Identitätsinfrastruktur: Angreifer erlangen administrative Zugangsdaten und nutzen Vertrauensstellungen zwischen den Active-Directory-Domänen der IT und der OT aus. Fokus der Untersuchung: Kerberos-Ticket-Anforderungen, Ereignisprotokolle der Domain-Controller (Ereignis-IDs 4624, 4672).
IT/OT-Grenz-Firewall: Angreifer nutzen Dual-Homed-Server oder offene RDP-/SSH-Regeln an der Netzwerkgrenze aus. Fokus der Untersuchung: Firewall-Statustabellen, Protokolle über blockierten/erlaubten Datenverkehr zwischen Ebene 4 und Ebene 3.5.
OT-DMZ (Ebene 3.5): Angreifer kompromittieren Jump-Boxes, Patch-Management-Server oder Historian-Spiegelungen, um in die Steuerungsnetzwerke vorzudringen. Fokus der Untersuchung: RDP-Sitzungsprotokolle von Jump-Hosts, PowerShell-Ausführungsprotokolle, Prozessstart-Ereignisse.
SCADA- / HMI-Infrastruktur (Ebene 3/2): Ransomware-Payloads werden auf Windows- oder Linux-basierten HMIs und Engineering Workstations ausgeführt und verschlüsseln Datenbankdateien sowie Projektverzeichnisse. Fokus der Untersuchung: Dateisystemänderungen auf Endgeräten, Anwendungsausführungsprotokolle, Prozessabstürze auf SCADA-Servern.
Kritische Fehler bei der Reaktion auf OT-Ransomware, die den Vorfall verschlimmern können
OT wie klassische IT behandeln: Die Ausführung automatisierter Skripte zur Isolation von Endgeräten in OT-Umgebungen kann zum Absturz kritischer HMIs führen oder Regelungskreise unterbrechen.
Netzwerke trennen, ohne Prozessabhängigkeiten zu prüfen: Das Trennen von Netzwerkverbindungen, ohne zu berücksichtigen, dass Feld-PLCs bestimmte Timing-Signale oder Verriegelungen im Netzwerk für den sicheren Betrieb benötigen.
Betroffene Systeme neu starten, bevor Beweise gesichert wurden: Das Aus- und Wiedereinschalten verschlüsselter HMIs oder Domain-Controller zerstört den flüchtigen Speicher (RAM), in dem sich Verschlüsselungs-Keys und aktive Malware-Artefakte befinden.
Wiederherstellung aus nicht validierten Backups: Das Einspielen von System-Images, ohne zu prüfen, ob das Backup schlafende Persistenzmechanismen des Angreifers oder manipulierte Konfigurationslogiken enthält.
Annehmen, dass Ransomware die einzige Aktivität ist: Die ausschließliche Fokussierung auf die Dateiverschlüsselung, während tiefer gehende Aktivitäten wie die Manipulation von SCADA-Logiken oder Eingriffe in Sicherheitssysteme übersehen werden.
Vernachlässigen kompromittierter Zugangsdaten: Das Löschen von Schadsoftware auf Endgeräten, während kompromittierte Domänenpasswörter, SSH-Schlüssel oder Fernzugriffstoken von Dienstleistern aktiv bleiben.
Ignorieren von Engineering Workstations (EWS): Die Beschränkung der Eindämmung auf HMIs, während EWS-Knoten, auf denen proprietäre PLC-Projektdateien und Steuerungssoftware liegen, unberücksichtigt bleiben.
Voreiliges Wiederverbinden operativer Netzwerke: Das Zurückschreiben wiederhergestellter OT-Segmente in das Unternehmensnetzwerk, bevor die IT-Umgebung vollständig bereinigt und gehärtet wurde.
Entscheidungsmatrix bei OT-Ransomware-Vorfällen
Nutzen Sie diese strukturierte Entscheidungsmatrix, um unter hohem Druck während eines aktiven Ransomware-Vorfalls in der Industrie fundierte Entscheidungen zu treffen:
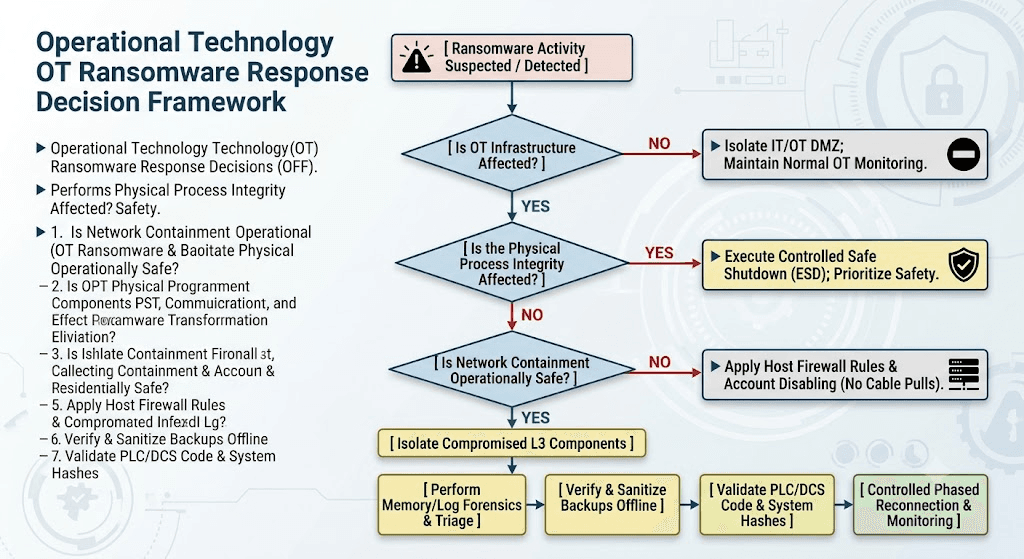
Wenn Ransomware ein operatives Netzwerk infiziert, ist das Stoppen der Schadsoftware der physischen Sicherheit und der Aufrechterhaltung der Prozesskontrolle untergeordnet.
Durch die Umsetzung dieser sieben strukturierten Schritte – Deklaration des Vorfalls, Gewährleistung der Sicherheit, präzise Eindämmung, umfassende Triage, vollständige Beseitigung von Persistenzen, sichere Wiederherstellung auf Basis sauberer Baselines und Stärkung der Systemresilienz – können Organisationen komplexe OT-Sicherheitsvorfälle erfolgreich bewältigen.
Bei der Reaktion auf OT-Ransomware definiert sich Erfolg nicht allein über die Geschwindigkeit, mit der Endgeräte wiederhergestellt werden, sondern primär über den Schutz von Menschenleben, die Aufrechterhaltung der physischen Prozesskontrolle, die Sicherung kritischer Beweise und die vertrauenswürdige Wiederinbetriebnahme des industriellen Betriebs.
Quellen und maßgebliche Referenzen
Dieses Reaktions-Framework orientiert sich an offiziellen Richtlinien von Behörden und internationalen Standards für die Cybersicherheit industrieller Steuerungssysteme:
NIST SP 800-82 Rev. 3: Guide to Operational Technology (OT) Security: Etabliert grundlegende Prinzipien für Sicherheit, Verfügbarkeit und Segmentierung in industriellen Netzwerken.
NIST SP 800-61 Rev. 3: Incident Response Recommendations and Considerations: Formuliert anpassbare Lebenszyklen zur Vorfallsbehandlung über verschiedene Organisationsbereiche hinweg.
NIST Cybersecurity Framework (CSF) 2.0 & Ransomware Risk Management Profile (NIST IR 8374): Beschreibt grundlegende Sicherheitsniveaus und Wiederherstellungsrichtlinien speziell für Ransomware-Bedrohungen.
CISA ICS Incident Handling Guidance: Bietet verfahrenstechnische Vorgaben für den Umgang mit operativen Vorfällen in kritischen Infrastruktursektoren.
ISA/IEC 62443-Reihe: Definiert technische Standards für Sicherheitsstufen, Zonen- und Conduits-Segmentierung sowie Risikoanalysen in der industriellen Automatisierung.
Wöchentlich erhalten
Ressourcen & Nachrichten
Erfahren Sie, wie unsere branchenführenden OT-Security-Lösungen kritische Sicherheitsherausforderungen gemäß KRITIS-Anforderungen bewältigen
Dies könnte Ihnen auch gefallen.

What the French supermarket cyberattack reveals about OT security
Prayukth K V

Inside the Albert Heijn cyber incident: Investigating the attack, the IT/OT exposure, and the risks to critical operations
Team Shieldworkz

50°C by cyberattack? Inside France’s supermarket refrigeration crisis
Prayukth K V

Automating IEC 62443 Compliance Assessments Without Losing Expert Control
Team Shieldworkz

Investigative cyber threat intelligence report: Daiichi Kosho supply-chain data exposure
Prayukth K V

How AI Is Changing IEC 62443 Assessments
Team Shieldworkz







