

Automatisierung des Incident Response mit modernen NDR-Sicherheitskontrollen


Team Shieldworkz
Ein Ransomware-Alarm auf einem Firmen-Laptop und der Stillstand eines Hochofens sollten sich niemals wie derselbe Notfall anfühlen. In den meisten heutigen Industrieumgebungen lösen sie jedoch dieselbe langsame, manuelle Hektik aus. Sicherheitsteams verbringen nach wie vor wertvolle Stunden damit, Protokolle manuell auszuwerten, Werksingenieure anzurufen, um die tatsächliche Funktion eines Geräts zu bestätigen, und Switches manuell zu isolieren, während die Produktion blind weiterläuft. Genau in dieser Lücke zwischen Erkennung (Detection) und Eindämmung (Containment) agieren die Angreifer. Moderne Network Detection and Response, aufgesetzt auf einer disziplinierten Netzwerksegmentierung und einer Zero-Trust-Architektur, ist genau dafür ausgelegt, diese Lücke zu schließen.
Dies ist keine theoretische Sorge für OT-Sicherheitsverantwortliche, ICS-Ingenieure, Werksleiter und CISOs, die Fertigungs-, Energie- und KRITIS-Umgebungen beaufsichtigen. Es ist die operative Realität, die Budgetgespräche, Risikobewertungen auf Vorstandsebene und Versicherungsverlängerungen im gesamten Industriesektor bestimmt. Zu verstehen, wie automatisierte Vorfallreaktion (Incident Response) tatsächlich funktioniert und warum sie vollständig von der zugrunde liegenden Segmentierung und dem Vertrauensmodell abhängt, gehört heute zu den Kernkompetenzen aller, die für die Sicherheit, Verfügbarkeit und Resilienz industrieller Abläufe verantwortlich sind.
Die Angriffsfläche hat sich in die Produktionshalle verlagert
Jahrzehntelang wurden industrielle Steuerungssysteme durch eine einfache Annahme geschützt: Sie seien isoliert. Air-Gapped-Netzwerke, proprietäre Protokolle und spezialisierte Hardware bildeten einen natürlichen Schutzwall um speicherprogrammierbare Steuerungen (PLC), Fernwirksysteme (RTU) und Prozessleitsysteme (SCADA). Dieser Schutzwall ist weitgehend verschwunden. IT- und OT-Netzwerke sind aus Effizienzgründen konvergiert, externe Dienstleister benötigen Zugriff für Wartungsarbeiten, cloudbasierte Historian- und Analyseplattformen rufen Daten direkt aus der Produktion ab, und dieselben Ransomware-Gruppen, die es auf Krankenhäuser und Banken abgesehen haben, haben gelernt, dass Industriebetriebe schnell zahlen, um Produktionsausfälle zu vermeiden.
Mehrere öffentlich dokumentierte Vorfälle verdeutlichen, wie schnell dieser Wandel vonstattenging. Bei den Angriffen auf das ukrainische Stromnetz in den Jahren 2015 und 2016 wurde Schadsoftware eingesetzt, die Leistungsschalter und Umspannwerkgeräte direkt manipulierte. Dies führte zum Stromausfall bei Hunderttausenden von Kunden und bewies, dass Angreifer tief in die operative Technologie (OT) und nicht nur in IT-Systeme eindringen können. Im Jahr 2017 wurde die Schadsoftware Triton (auch bekannt als Trisis) entdeckt, die gezielt auf die sicherheitsgerichteten Systeme (SIS) einer petrochemischen Anlage in Saudi-Arabien abzielte – genau jene Steuerungen, die Explosionen verhindern und Menschenleben schützen sollen. Dieser Vorfall bleibt eine der eindringlichsten Warnungen für den Industriesektor: Angreifer haben es nicht mehr nur auf Daten abgesehen, sie manipulieren Systeme, die für die physische Sicherheit von Menschen verantwortlich sind.
Näher an der Heimat vieler Hersteller erzwang der Ransomware-Angriff auf Norsk Hydro im Jahr 2019, dass der Aluminiumproduzent große Teile seines Betriebs wochenlang auf manuelle Prozesse umstellen musste – mit Kosten in zweistelliger Millionenhöhe. Und der Vorfall bei der Colonial Pipeline im Jahr 2021 zeigte, wie ein Angriff, der technisch auf die IT-Systeme beschränkt war, Betreiber dennoch dazu zwingen konnte, eine gesamte Kraftstoffpipeline vorsorglich abzuschalten, da das Vertrauen in die Trennung zwischen Geschäftsnetzwerk und operativem Netzwerk fehlte. Keines dieser Unternehmen handelte fahrlässig. Es fehlte ihnen schlicht an der Segmentierung, der Transparenz und den automatisierten Reaktionsfähigkeiten, die erforderlich sind, um einen Vorfall einzudämmen, bevor er einen Stillstand erzwingt.
Warum manuelle Vorfallreaktion in Industrieumgebungen nicht mehr funktioniert
Das traditionelle Incident-Response-Modell wurde für die IT entwickelt: Ein Analyst prüft einen Alarm, kontrolliert einige Systeme und entscheidet, ob ein Laptop isoliert oder ein Benutzerkonto zurückgesetzt werden soll. Auf die OT übertragen, versagt dieses Modell in dreifacher Hinsicht.
Die Verweilzeit (Dwell Time) ist länger und gefährlicher. Industrielle Eindringlinge bleiben historisch gesehen über längere Zeiträume unentdeckt, da der OT-Datenverkehr selten mit derselben Intensität wie der IT-Datenverkehr überwacht wird. Dies gibt Angreifern Zeit, das Netzwerk auszukundschaften und hochkarätige Ziele wie Sicherheitssysteme zu identifizieren.
Die Alarmmüdigkeit (Alert Fatigue) schlägt härter zu. Herkömmliche Intrusion-Detection-Tools, die für die Unternehmens-IT entwickelt wurden, erzeugen enorme Mengen an Rauschen, wenn sie auf OT-Protokolle angewendet werden, für deren Analyse sie nie konzipiert wurden. Dadurch gehen die wenigen tatsächlich gefährlichen Alarme unter.
Eindämmungsentscheidungen haben physische Konsequenzen. Ein Analyst kann nicht einfach die Stromversorgung eines Segments trennen, wie er einen kompromittierten Laptop isolieren würde. Ein falsches Vorgehen kann ein Sicherheitsereignis auslösen, Anlagen beschädigen oder einen Prozess stoppen, dessen sicheres Wiederanfahren Stunden in Anspruch nimmt.
Das Ergebnis ist ein Reaktionszyklus, der in Stunden oder Tagen statt in Minuten gemessen wird – genau das Zeitfenster, das Angreifer benötigen, um vom Erstzugang zu realen operativen Auswirkungen überzugehen. Um dieses Fenster zu schließen, müssen zwei Faktoren zusammenwirken: eine Automatisierung, die den OT-Kontext versteht, und eine segmentierte Netzwerkarchitektur, die eine schnelle und sichere Eindämmung überhaupt erst ermöglicht.
Die wirtschaftlichen Kosten einer verzögerten Eindämmung
Sicherheitsverantwortliche erhalten Budgets für neue Werkzeuge oft, indem sie über die Wahrscheinlichkeit von Sicherheitsvorfällen sprechen. In Industrieumgebungen ist die überzeugendere Kennzahl meist einfacher: die Kosten für jede Stunde, in der eine Anlage, eine Produktionseinheit oder ein Werk stillsteht, während ein Team manuell untersucht, was passiert ist. Ungeplante Stillstandszeiten in Branchen mit kontinuierlichen Prozessen wie Chemie, Energie und Schwerindustrie belaufen sich schnell auf Zehntausende von Euro pro Stunde, wenn entgangene Produktion, unbrauchbare Materialien, Vertragsstrafen und Anfahrkosten zusammenkommen. Eine vorsorgliche Komplettabschaltung mehrerer Linien vervielfacht diesen Betrag rasant.
Eine verzögerte Eindämmung potenziert diese Kosten in dreifacher Weise. Erstens steigt der direkte Produktionsverlust mit jeder Stunde, in der ein Vorfall ungelöst bleibt. Zweitens weitet sich der Umfang einer manuellen Untersuchung tendenziell aus, da aus Vorsicht immer mehr Systeme vom Netz genommen werden, weil niemand verlässlich sagen kann, welche Bereiche tatsächlich betroffen sind. Drittens dauert die Wiederherstellung selbst länger, da das sichere Wiederanfahren komplexer industrieller Prozesse nach einem ungeplanten Stopp selten so einfach ist wie das Umlegen eines Schalters. Oft müssen Sicherheitsverriegelungen und Prozessparameter neu validiert werden, bevor die Produktion wieder aufgenommen werden kann.
Reaktionsmodell | Typisches Zeitfenster von Erkennung bis Eindämmung | Umfang der vorsorglichen Abschaltung |
Manuelle, logbasierte Untersuchung | Stunden bis mehrere Tage | Aus Vorsicht oft werksweit oder über mehrere Linien hinweg |
NDR-Alarme ohne automatisierte Reaktion | Unter einer Stunde bis zur Erkennung, Stunden bis zur Aktion | Reduziert, aber weiterhin von manueller Ausführung abhängig |
Automatisierte NDR + SOAR mit Segmentierung | Minuten von der Erkennung bis zur ersten Eindämmungsmaßnahme | Streng begrenzt auf die spezifisch betroffene, segmentierte Zone |
Tabelle 3: Wie der Reifegrad der Vorfallreaktion die operativen Kosten eines Vorfalls direkt beeinflusst.
So betrachtet, sind automatisierte Incident Response und Segmentierung keine reinen Sicherheitsausgaben mehr, sondern fallen unter das operative Risikomanagement – dieselbe Investitionskategorie wie Notstromaggregate oder redundante Sicherheitssysteme, gerechtfertigt durch vermiedene Stillstandszeiten statt durch die bloße Vermeidung von Sicherheitsvorfällen.
Was moderne NDR für OT-Netzwerke tatsächlich bedeutet
Network Detection and Response, die für Industrieumgebungen entwickelt wurde, ist eine grundlegend andere Disziplin als die Intrusion-Detection-Tools, die die meisten IT-Teams bereits einsetzen. Generische, IT-fokussierte Tools prüfen Paket-Header und gleichen bekannte Signaturen ab; sie wurden nie dafür konzipiert, Modbus, DNP3, EtherNet/IP oder proprietäre Herstellerprotokolle zu analysieren, und sie können nicht zwischen einem geplanten Wartungsbefehl und einem böswilligen Befehl unterscheiden. Speziell entwickelte OT-NDR-Plattformen erstellen stattdessen eine Verhaltens-Baseline für jedes Asset im Netzwerk – mit wem es kommuniziert, welche Befehle es normalerweise sendet und wie ein sicheres Betriebsmuster aussieht. Abweichungen von dieser Baseline werden in Echtzeit gemeldet, ohne dass aktive, störende Scans erforderlich sind, die empfindliche Steuerungssysteme beeinträchtigen könnten.
Funktion | Traditionelle IT-zentrierte Überwachung | Speziell entwickelte OT Network Detection & Response |
Protokoll-Verständnis | Unterstützt ausschließlich gängige IT-Protokolle | Analysiert Industrieprotokolle (u. a. Modbus, DNP3, EtherNet/IP, OPC-UA) |
Erkennungsmethode | Aktives Scannen, oft störend für den Betrieb | Passives, zerstörungsfreies Monitoring des Datenverkehrs, sicher für Altsysteme |
Erkennungslogik | Abgleich von Signaturen und CVEs | Verhaltensbasierte Baseline von Assets, Befehlen und Prozesslogik |
Asset-Transparenz | Begrenzt auf vernetzte IT-Endpunkte | Vollständiges Inventar von PLCs, RTUs, HMIs, Sensoren und Engineering-Workstations |
Reaktionsgeschwindigkeit | Manuelle Triagierung, Stunden bis Tage | Automatisierte Triagierung und orchestrierte Eindämmung in Minuten |
Sicherheitsausrichtung | Nicht für funktionale Sicherheit (Safety) ausgelegt | Reaktionsmaßnahmen sind auf operative und funktionale Sicherheitsauswirkungen abgestimmt |
Tabelle 1: Wie sich speziell entwickelte OT-Netzwerkbesserung von generischen IT-Überwachungstools unterscheidet.
Diese verhaltensbasierte, protokollsensitive Grundlage ist es, die Automatisierung in einem OT-Kontext vertrauenswürdig macht. Ein automatisiertes System kann nur dann sichere Maßnahmen ergreifen, wenn es wirklich versteht, wie der Normalbetrieb in diesem spezifischen Netzwerk aussieht. Genau aus diesem Grund richtet das Aufpropfen eines generischen IT-Tools auf eine Produktionslinie oft mehr Schaden als Nutzen an.
Automatisierung des Incident Response Lifecycles
Bei der Automatisierung der OT-Vorfallreaktion geht es nicht darum, den Menschen aus dem Prozess auszuschließen. Es geht darum, die Verzögerung zwischen der Erkennung und der ersten sicheren Eindämmungsmaßnahme zu beseitigen, damit menschliche Experten ihre Zeit für fundierte Entscheidungen nutzen können, anstatt Rohdaten hinterherzujagen. Ein ausgereifter automatisierter Workflow durchläuft im Allgemeinen sechs Phasen, von denen jede die nächste speist, ohne dass eine Person manuell eingreifen muss.
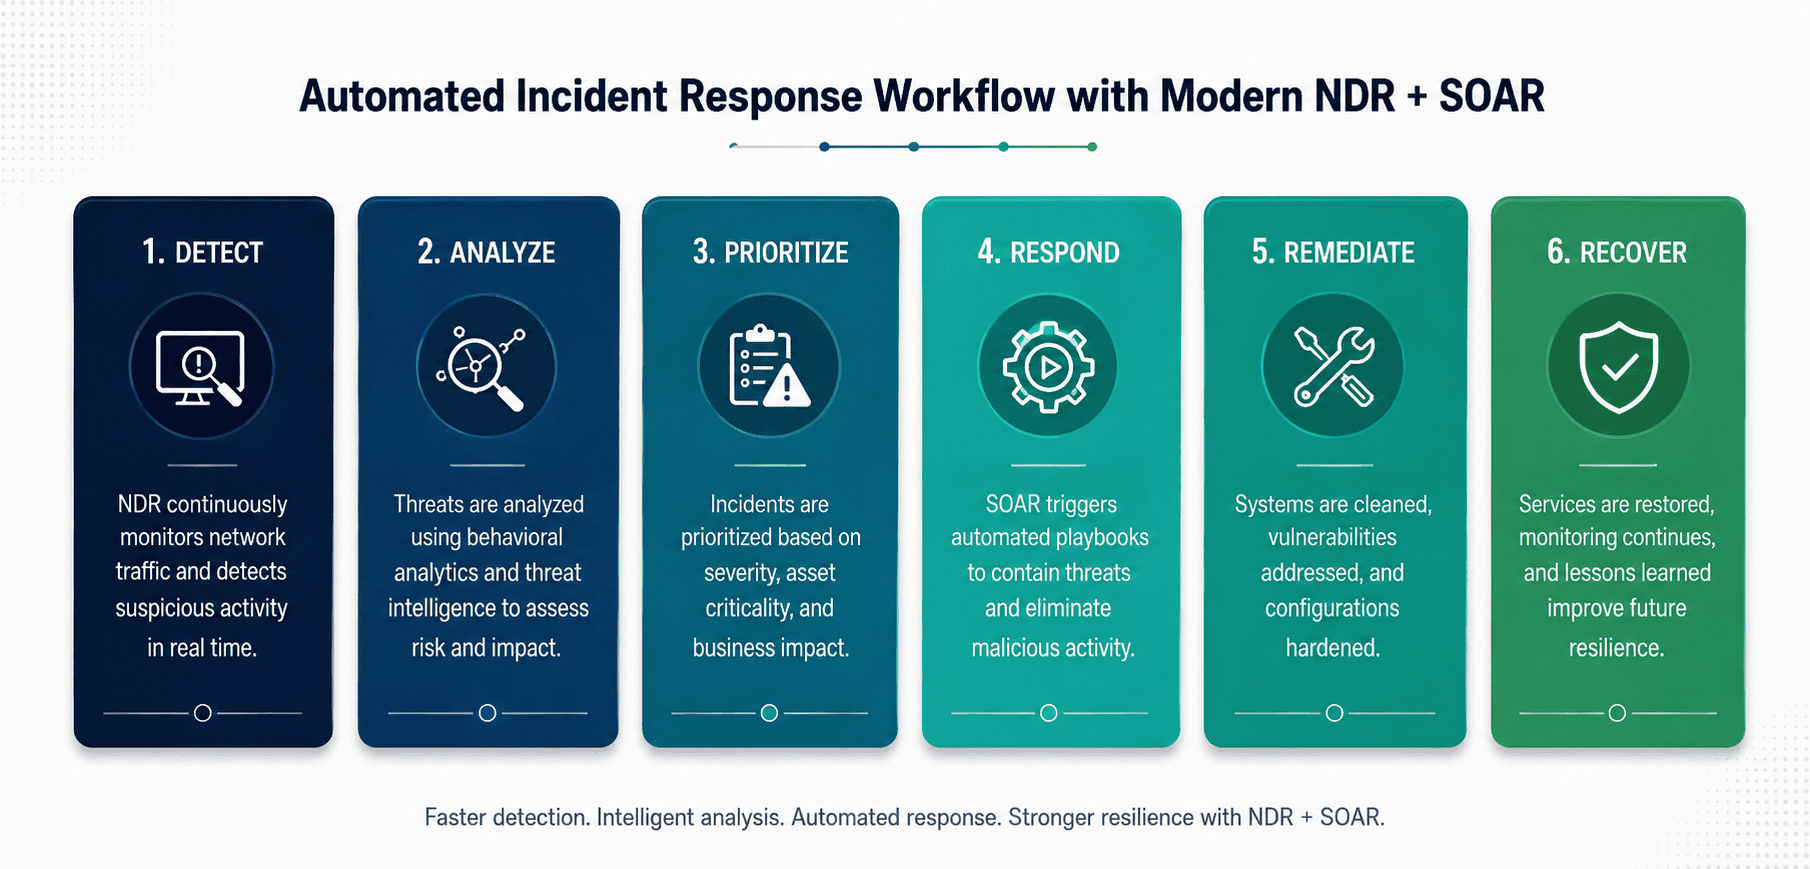
Abbildung 1: Eine moderne automatisierte Incident-Response-Pipeline, die OT-sensitive NDR-Sensoren mit einer SOAR-gesteuerten Orchestrierung verbindet.
1. Erkennen (Detect)
An zentralen Netzwerkknotenpunkten positionierte Sensoren vergleichen den Live-Datenverkehr kontinuierlich mit der etablierten Verhaltens-Baseline. Sie melden Anomalien, wenn beispielsweise eine Engineering-Workstation plötzlich Schreibbefehle an eine Steuerung sendet, mit der sie zuvor nie kommuniziert hat.
2. Anreichern (Enrich)
Rohalarme werden automatisch mit Asset-Kontext, Gerätetyp, Firmware-Version, Kritikalität und physischem Standort angereichert und mit aktuellen Bedrohungsdaten (Threat Intelligence) abgeglichen. So wird aus einem bloßen Netzwerkereignis ein vollständig kontextualisierter Vorfall.
3. Triagieren (Triage)
Eine automatisierte Bewertung gewichtet den angereicherten Alarm anhand der betrieblichen und sicherheitsrelevanten Auswirkungen. Dadurch wird eine routinemäßige Wartungsanomalie von einer glaubwürdigen Bedrohung für ein sicherheitsgerichtetes System unterschieden, sodass sich Analysten ausschließlich auf das Wesentliche konzentrieren können.
4. Orchestrieren (Orchestrate)
Bei Alarmen, die einen definierten Risikoschwellenwert überschreiten, werden vorab freigegebene Playbooks automatisch ausgeführt: Firewall-Regeln werden verschärft, eine verdächtige Remote-Sitzung wird beendet oder ein Gerät wird in ein eingeschränktes VLAN verschoben – ohne dass ein Mensch den ersten Befehl eintippen muss.
5. Eindämmen (Contain)
Eindämmungsmaßnahmen werden präzise auf das betroffene Segment eingegrenzt. So kann ein kompromittiertes HMI isoliert werden, ohne die umliegenden Sicherheitssteuerungen oder Produktionslinien zu beeinträchtigen. Die Verfügbarkeit bleibt gewahrt, während die Reichweite der Bedrohung eliminiert wird.
6. Berichten (Report)
Jede Maßnahme, jeder Zeitstempel und jeder Entscheidungspunkt wird automatisch in einer forensischen Timeline protokolliert. Diese steht für das SOC, Regulierungsbehörden, Versicherer und die Geschäftsführung bereit. Was früher Tage der nachträglichen Rekonstruktion erforderte, ist nun sofort als Bericht verfügbar.
Netzwerksegmentierung: Das Fundament für sichere Automatisierung
Keine der oben beschriebenen Automatisierungen kann sicher implementiert werden, ohne dass ein bewusst segmentiertes Netzwerk zugrunde liegt. Erst die Segmentierung ermöglicht es einem automatisierten Playbook, eine kompromittierte Zone mit chirurgischer Präzision zu isolieren, anstatt aus Vorsicht eine werksweite Abschaltung auszulösen. Die meisten Industrieumgebungen orientieren sich lose am Purdue-Referenzmodell. Jede Ebene dieses Modells stellt sowohl eine funktionale als auch eine Sicherheitsgrenze dar, die durchgesetzt und nicht nur dokumentiert werden sollte.
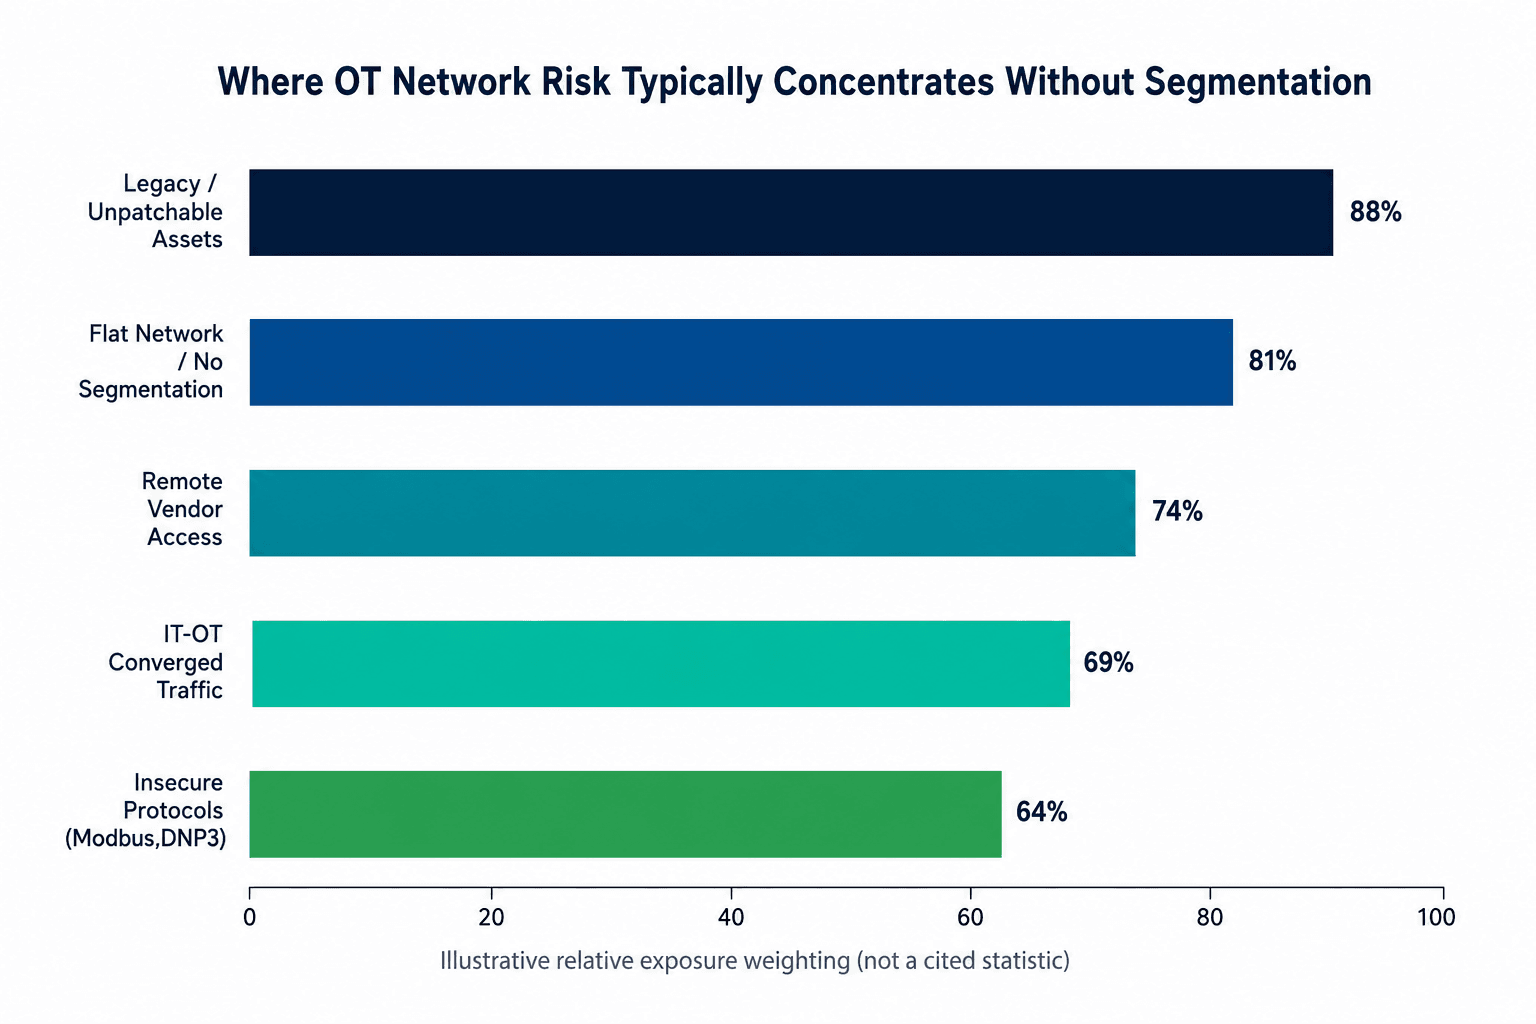
Abbildung 2: Anwendung der Zero-Trust-Verifizierung an jeder Grenze des Purdue-Modells, von der Unternehmens-IT bis zu den Feldgeräten.
Purdue-Ebene | Komponenten | Segmentierungspriorität |
Ebene 5, Unternehmens-IT | Unternehmensanwendungen, E-Mail, Cloud-Dienste | Strikte Trennung von der OT; kein direkter Zugriff auf die Steuerungsebene |
Ebene 4, Betriebsplanung | ERP, Logistik, Berichtssysteme | Datenflüsse nach Möglichkeit nur unidirektional in Richtung OT |
Ebene 3, Betriebsführung & MES | Produktionssteuerung (MES), Historians, Patch-Server | Vermittlung des gesamten Datenverkehrs über eine überwachte DMZ |
DMZ | Jump-Server, replizierte Historians, Gateways für Fernzugriff | Zero-Trust-Durchsetzungspunkt; jede Sitzung wird verifiziert |
Ebene 2, Prozessleitebene | SCADA, HMI, Engineering-Workstations | Mikrosegmentiert nach Produktionslinie oder -zelle |
Ebene 0-1, Feldebene | PLCs, RTUs, Sensoren, Aktoren | Isolierte Gerätegruppen mit streng begrenztem Ost-West-Zugriff |
Tabelle 2: Segmentierungsprioritäten, zugeordnet zu den einzelnen Ebenen des Purdue-Referenzmodells.
Unternehmen, die sich am schnellsten von einem OT-Sicherheitsvorfall erholen, sind fast nie diejenigen, die jeden Angriff verhindert haben. Es sind diejenigen, deren Netzwerkarchitektur die laterale Bewegung eines Angreifers physisch einschränkte. Segmentierung verwandelt einen potenziellen werksweiten Notfall in ein lokal begrenztes Ereignis in einer einzelnen Zelle, das automatisierte Tools in wenigen Minuten neutralisieren können.
Anwendung von Zero-Trust-Prinzipien in OT-Umgebungen
Zero Trust wird oft als reines IT-Konzept diskutiert. Seine drei Kernprinzipien lassen sich jedoch direkt auf die industrielle Welt übertragen – mit einigen wichtigen Anpassungen an die Realitäten von Altsystemen und kontinuierlichem Betrieb.
Explizit verifizieren: Jede Sitzung – ob über das Fernwartungstool eines Dienstleisters, einen Engineering-Laptop oder einen Historian-Datenabruf – wird basierend auf Identität und Kontext authentifiziert und autorisiert, und nicht einfach, weil sie aus dem internen Werksnetzwerk stammt.
Minimale Rechte vergeben (Least Privilege): Bediener, Ingenieure oder externe Integratoren erhalten nur Zugriff auf genau die Systeme und Funktionen, die für ihre Rolle erforderlich sind. Dies schränkt den potenziellen Schaden durch kompromittierte Zugangsdaten drastisch ein.
Vom schlimmsten Fall ausgehen (Assume Breach): Architektur und Überwachung sind so konzipiert, dass davon ausgegangen wird, dass ein Angreifer irgendwann Fuß fassen wird. Die Priorität verlagert sich somit von der Verhinderung jedes Eindringens hin zur Begrenzung des Schadensradius (Blast Radius) und der sofortigen Erkennung von lateralen Bewegungen.
Richtig angewendet bedeutet Zero Trust nicht, dass jede Aktion des Bedieners in der Produktionshalle erschwert wird. Es bedeutet vielmehr, das implizite Vertrauen abzuschaffen, auf das sich flache OT-Netzwerke jahrzehntelang verlassen haben – die Annahme, dass alles innerhalb des Perimeters sicher sei –, und es durch eine kontinuierliche, kontextbezogene Verifizierung an den kritischsten Punkten zu ersetzen: der DMZ, den Fernzugriffs-Gateways und den Grenzen zwischen den Produktionszellen.
Risiken, Herausforderungen und Branchenerkenntnisse
Selbst Organisationen, die die Notwendigkeit einer automatisierten Reaktion und Segmentierung erkennen, stoßen bei der Implementierung auf vorhersehbare Hindernisse. Diese Herausforderungen im Vorfeld zu verstehen, unterscheidet eine erfolgreiche Einführung von einer, die den Betrieb stört.
Altsysteme und nicht patchbare Assets: Viele Feldgeräte nutzen Software, die ohne Beteiligung des Herstellers oder ein vollständiges Wartungsfenster nicht aktualisiert werden kann. Segmentierung und Überwachung müssen daher Schwachstellen kompensieren, die nicht direkt gepatcht werden können.
Flache, undokumentierte Netzwerke: Über Jahrzehnte gewachsene oder erweiterte Werke weisen häufig weitaus mehr Ost-West-Verbindungen auf, als den Verantwortlichen bewusst ist. Eine vollständige Asset- und Datenverkehrsanalyse ist daher meist der erste notwendige Schritt, bevor eine Segmentierung überhaupt geplant werden kann.
Fernzugriff durch Dritte und Wartungspartner: Wartungsverträge erfordern oft, dass externe Ingenieure auf bestimmte Steuerungen zugreifen können. Ohne einen begrenzten, zeitlich gesteuerten und überwachten Zugriff wird dieser Pfad zu einem der häufigsten Einfallstore für Angreifer in ein OT-Netzwerk.
Konvergenter IT-OT-Datenverkehr: Dieselbe Konnektivität, die vorausschauende Wartung und Echtzeit-Analysen ermöglicht, schafft auch eine Brücke, über die sich Angreifer von einem kompromittierten Büro-Laptop bis in die Produktionshalle vorarbeiten können.
Unsichere Protokolle (Insecure-by-Design): Viele Industrieprotokolle wurden vor Jahrzehnten ohne Authentifizierung oder Verschlüsselung entwickelt. Daher müssen Überwachung und Segmentierung die Sicherheitslast tragen, die das Protokoll selbst nicht leisten kann.
Fachkräftemangel und Qualifikationslücken: Auf IT-Tools geschulte Sicherheitsteams verfügen oft nicht über das erforderliche OT-Prozesswissen, um zu beurteilen, ob eine Eindämmungsmaßnahme sicher ist. Genau diese Lücke sollen gut konzipierte Automatisierungen und Playbooks schließen.
Keine dieser Herausforderungen ist ein Grund zum Zögern. Es sind genau jene Probleme, die ein schrittweises Segmentierungs- und Automatisierungsprogramm lösen soll – Zone für Zone, ohne eine störende, allumfassende Netzwerküberholung zu erzwingen.
Regulatorische Dynamik macht dies unumgänglich
Über das operative Risiko hinaus hat sich die regulatorische Landschaft im Bereich der industriellen Cybersicherheit entscheidend verändert. Sie verlangt nun genau jene Fähigkeiten, die in diesem Artikel beschrieben werden. Standards wie die IEC 62443 fordern explizit die Segmentierung von Netzwerken in Sicherheitszonen und Conduits als grundlegende Sicherheitsmaßnahme für industrielle Automatisierungssysteme. In Europa verpflichtet die NIS-2-Richtlinie Betreiber kritischer Infrastrukturen (KRITIS) zu strengen Risikomanagement- und Berichtspflichten, die ohne kontinuierliches Monitoring und Segmentierung kaum zu erfüllen sind. Auch in Nordamerika erlegen die NERC-CIP-Anforderungen den Betreibern von Stromnetzen spezifische Pflichten auferlegen. Eine wachsende Zahl von Rechtsordnungen erwartet zudem eine zeitnahe Meldung von Sicherheitsvorfällen bei KRITIS-Betreibern, was weitaus einfacher zu erfüllen ist, wenn automatisierte Tools bereits eine lückenlose forensische Timeline generieren.
Keines dieser Regelwerke schreibt einen bestimmten Anbieter oder ein bestimmtes Produkt vor, aber fast alle laufen auf dieselben Erwartungen hinaus: Kennen Sie Ihre Assets, segmentieren Sie Ihr Netzwerk, überwachen Sie kontinuierlich und weisen Sie eine geprüfte Incident-Response-Fähigkeit nach. Organisationen, die sich proaktiv an diesen Prinzipien ausrichten, erleben Compliance-Audits als weitaus weniger belastend als jene, die versuchen, eine Dokumentation nachträglich auf ein nie vollständig erfasstes Netzwerk aufzupfropfen.
Praktische Empfehlungen und Best Practices
Organisationen, die ihre Incident-Response-Fähigkeiten erfolgreich modernisieren, folgen meist einer klaren Abfolge: Transparenz vor Automatisierung und Segmentierung vor Durchsetzung.
Starten Sie mit einer vollständigen Asset- und Traffic-Inventarisierung: Sie können keine Geräte segmentieren, bewerten oder automatisieren, von deren Existenz Ihr Team nichts weiß.
Etablieren Sie zuerst ein passives Monitoring: Ein zerstörungsfreies, OT-sensitives NDR sollte laufen und eine Verhaltens-Baseline erstellen, lange bevor automatisierte Eindämmungsmaßnahmen aktiviert werden.
Segmentieren Sie schrittweise nach Produktionszonen: Statt einer werksweiten Neugestaltung sollten Sie zuerst die risikoreichsten oder wertvollsten Zellen isolieren und den Bereich mit wachsendem Vertrauen sukzessive ausweiten.
Bauen Sie eine DMZ auf, die Zero Trust tatsächlich durchsetzt: Jeder Datenfluss zwischen IT und OT, einschließlich Historian-Replikation und Fernzugriff, muss über ein überwachtes Gateway geleitet werden, nicht über Direktverbindungen.
Definieren Sie Playbooks gemeinsam mit dem Betrieb, nicht nur mit der IT-Sicherheit: Eindämmungsmaßnahmen müssen vor ihrer Automatisierung von Werksingenieuren geprüft und freigegeben werden, die die Auswirkungen auf die funktionale Sicherheit und die Prozesse verstehen.
Begrenzen und überwachen Sie alle Zugriffe Dritter: Sitzungen von Dienstleistern und Integratoren müssen auf spezifische Systeme beschränkt, vollständig protokolliert und nach Ablauf des Wartungsfensters automatisch beendet werden.
Testen Sie Response-Playbooks regelmäßig: Tabletop-Übungen und simulierte Vorfälle halten sowohl die Automatisierung als auch das menschliche Team für den Ernstfall bereit und decken Schwachstellen auf, bevor Angreifer es tun.
Berichten Sie Kennzahlen, die für die Führungsebene relevant sind: Die mittlere Zeit bis zur Erkennung (MTTD), die mittlere Zeit bis zur Eindämmung (MTTC) und der Abdeckungsgrad der Segmentierung bieten dem Vorstand ein klares Bild der sich kontinuierlich verbessernden Resilienz.
Die erfolgreichsten Programme entfalten sich in drei bewussten Phasen statt in einem einzigen, riskanten Großprojekt. Dies hält das operative Risiko gering und liefert dennoch bereits in den ersten Monaten messbare Fortschritte.
Phase | Hauptfokus | Typisches Ergebnis |
Phase 1: Transparenz (Visibility) | Asset-Erkennung, passives Monitoring des Datenverkehrs, Verhaltens-Baseline | Ein vollständiges, präzises Bild aller tatsächlich im Netzwerk befindlichen Komponenten |
Phase 2: Segmentierung | DMZ-Durchsetzung, Zonen- und Conduit-Design, Fernzugriffskontrollen | Begrenzter Schadensradius und durchgesetzte Least-Privilege-Grenzen |
Phase 3: Automatisierung | SOAR-Playbooks, orchestrierte Eindämmung, kontinuierliche Tests | Eindämmung in Minutenschnelle bei minimalem manuellem Aufwand |
Tabelle 4: Ein phasenweise Ansatz, der Automatisierung auf einem Fundament aus Transparenz und Segmentierung aufbaut.
Häufig gestellte Fragen (FAQ)
Ist eine Netzwerksegmentierung ohne Unterbrechung der laufenden Produktion möglich?
Ja, wenn sie als phasenweise Einführung geplant wird, die mit einer passiven Analyse beginnt. Segmentierungsprojekte, die scheitern, sind fast immer jene, die direkt zur Durchsetzung übergehen, ohne zuvor die realen Kommunikationsmuster verstanden zu haben. Ein sorgfältiger, zonenweiser Ansatz verhindert ungeplante Unterbrechungen.
Kann eine automatisierte Reaktion versehentlich einen sicherheitskritischen Prozess abschalten?
Nur dann, wenn die Playbooks unzureichend konzipiert sind. Eine solide Automatisierung beschränkt sich präzise auf Maßnahmen auf der Netzwerkschicht – wie das Isolieren eines Switch-Ports oder das Einschränken eines VLANs – und wird gemeinsam mit den Prozessingenieuren entwickelt, sodass sie sicherheitsgerichtete Systeme (SIS) niemals direkt beeinträchtigt.
Wie unterscheidet sich OT-fokussierte NDR von einer IT-Firewall oder einem Antivirentool?
Firewalls und Antivirentools kontrollieren den Zugriff und blockieren bekannte Schaddateien; sie verstehen jedoch keine Industrieprotokolle oder verhaltensbezogenen Kontexte. OT-NDR ist speziell dafür ausgelegt, die tatsächliche Kommunikation der Geräte zu überwachen und Abweichungen von diesem Muster zu melden – genau dort, wo sich reale ICS-Angriffe letztlich offenbaren.
Was sollte ein Werksleiter von einer ersten Bestandsaufnahme erwarten?
Eine verlässliche Bewertung beginnt mit einer passiven Netzwerkanalyse, nicht mit störenden Scans. Sie sollte ein klares Asset-Inventar, eine Lückenanalyse zur Segmentierung und priorisierte Empfehlungen liefern, die an das tatsächliche operative Risiko gekoppelt sind – anstelle einer generischen Checkliste.
Wie Shieldworkz Unternehmen unterstützt
Shieldworkz arbeitet eng mit Industriebetrieben, Werksingenieuren und Sicherheitsverantwortlichen zusammen, um eine Vorfallreaktion und Netzwerkarchitektur aufzubauen, die den Realitäten des Live-Betriebs gerecht wird – ohne auf generische Schablonen aus der Unternehmens-IT zurückzugreifen.
Umfassende OT-Asset-Erkennung und Netzwerkkartierung über passive, zerstörungsfreie Methoden, die niemals das Risiko bergen, empfindliche Steuerungssysteme zu stören.
Speziell entwickelte Netzwerkerkennung, die auf Industrieprotokolle abgestimmt ist und Sicherheitsteams eine Verhaltens-Baseline bietet, anstatt sie mit einer Flut irrelevanter IT-Alarme zu überfordern.
Zero-Trust-Segmentierungsdesign, das am Purdue-Modell ausgerichtet und auf die spezifischen Produktionszonen, Dienstleister und Sicherheitsanforderungen jedes Standorts zugeschnitten ist.
Automatisierte Incident-Response-Playbooks, die gemeinsam mit Werks- und Prozessingenieuren entwickelt werden, sodass jede Eindämmungsmaßnahme die betrieblichen und sicherheitsrelevanten Rahmenbedingungen respektiert.
Kontinuierliche Überwachung, Bedrohungsdaten (Threat Intelligence) und Incident-Response-Unterstützung durch ein Team, das sowohl in der Cybersicherheit als auch im industriellen Betrieb versiert ist.
Berichte für die Geschäftsführung und den Vorstand, die technische Risiken in klare operative und finanzielle Begriffe übersetzen, um fundierte Entscheidungen zu ermöglichen.
Das Ziel ist klar: Reduzierung der Zeitspanne zwischen dem ersten Anzeichen einer Kompromittierung und der vollständigen Eindämmung – ohne das operative Risiko oder die Komplexität in Umgebungen zu erhöhen, in denen Verfügbarkeit und Sicherheit an erster Stelle stehen.
Fazit
Die Unternehmen, die für den nächsten großen industriellen Cyber-Vorfall am besten gerüstet sind, werden nicht diejenigen sein, die niemals angegriffen werden – jede vernetzte Industrieumgebung wird dies früher oder später erleben. Es werden diejenigen sein, die ein Eindringen in Minuten statt in Monaten erkennen, es auf eine einzige segmentierte Zone begrenzen und all dies ohne ungeplante Produktionsstopps bewältigen. Dieses Ergebnis ist nicht das Produkt eines einzelnen Tools. Es ist das Resultat aus speziell entwickelter Netzwerkerkennung, disziplinierter Zero-Trust-Segmentierung und automatisierter Reaktion, die als ein koordiniertes System zusammenwirken.
Der Aufbau eines solchen Systems erfordert eine gezielte Planung, tiefes OT-Prozesswissen und einen Partner, der versteht, dass eine Leitwarte kein Rechenzentrum ist. Je eher dieses Fundament steht, desto kleiner ist das Zeitfenster, das einem Angreifer bleibt, und desto sicherer kann das Betriebsteam den kontinuierlichen Betrieb gewährleisten.
Sind Sie bereit zu erfahren, wie es um die Sicherheit Ihres OT-Netzwerks steht?
Buchen Sie ein kostenloses und unverbindliches Beratungsgespräch mit dem industriellen Cybersicherheitsteam von Shieldworkz. Wir analysieren Ihre aktuelle Netzwerkarchitektur, besprechen praktische erste Schritte zur Segmentierung sowie zur automatisierten Reaktion und beantworten die Fragen, die sich auch Ihr Vorstand bereits stellt.
Buchen Sie jetzt ein kostenloses Beratungsgespräch mit unseren Experten
Zusätzliche Ressourcen:
Umfassender Leitfaden zu Network Detection and Response (NDR) im Jahr 2026 finden Sie hier
NERC CIP-015 Bereitschafts-Checkliste für die interne Netzwerksicherheitsüberwachung von Energieversorgungsunternehmen finden Sie hier
OT SOC Grundlagen-Leitfaden finden Sie hier
Managed SOC Service finden Sie hier
OT Cyber Threat Intelligence Advisory - Mittlerer Osten finden Sie hier
Erreichen der NIS-2-Konformität durch IEC 62443 finden Sie hier
Was sind Wechselmedien? Risiken, Richtlinien und industrielle OT-Sicherheitslösungen finden Sie hier
Kostenlose Richtlinienvorlage für Wechselmedien für OT- und IT-Teams finden Sie hier
Wöchentlich erhalten
Ressourcen & Nachrichten
Erfahren Sie, wie unsere branchenführenden OT-Security-Lösungen kritische Sicherheitsherausforderungen gemäß KRITIS-Anforderungen bewältigen
Dies könnte Ihnen auch gefallen.

Inside the Albert Heijn cyber incident: Investigating the attack, the IT/OT exposure, and the risks to critical operations
Team Shieldworkz

50°C by cyberattack? Inside France’s supermarket refrigeration crisis
Prayukth K V

Automating IEC 62443 Compliance Assessments Without Losing Expert Control
Team Shieldworkz

Investigative cyber threat intelligence report: Daiichi Kosho supply-chain data exposure
Prayukth K V

How AI Is Changing IEC 62443 Assessments
Team Shieldworkz

Deep investigative threat intelligence report: Alleged SafePay cyberattack on T-Systems
Team Shieldworkz







